页面选择
导出指定页面范围,同时保留原始页码。处理较长文档前,先检查小样本会更方便。

将可选择的文本、页面几何信息和文本位置导出为 JSON。
将文件拖到此处,或使用下方按钮选择文件。
上限为 25 MB 总计 · 文件保留在您的设备上
在此预览文档。对于新添加的内容,预览仅用于辅助确定位置;请检查保存后的输出结果。
将 PDF 的文本层转换为 JSON 文件,便于检查或进一步处理。导出内容记录所选页面、页面尺寸,以及 PDF 阅读器返回的文本项,包括它们的位置和变换信息。
PDF 存储的是页面显示指令。本工具不会推断发票字段、重建表格或识别原始标题层级。扫描页面需要先进行 OCR 文字识别,其中的文字才能出现在导出结果中。
导出指定页面范围,同时保留原始页码。处理较长文档前,先检查小样本会更方便。
将文本项与页面几何信息和定位信息一同保留。请参照原始 PDF 解读坐标,并核实各项在视觉上的关系。
下载有效的 JSON,用于您自己的解析器或审核流程。导出的文本会作为数据进行转义;工具不会执行文档内容。
在浏览器中读取所选 PDF。文档不会发送到转换服务器,原始文件也不会被修改。
选择包含可选择文本的 PDF。
点击截图可放大查看。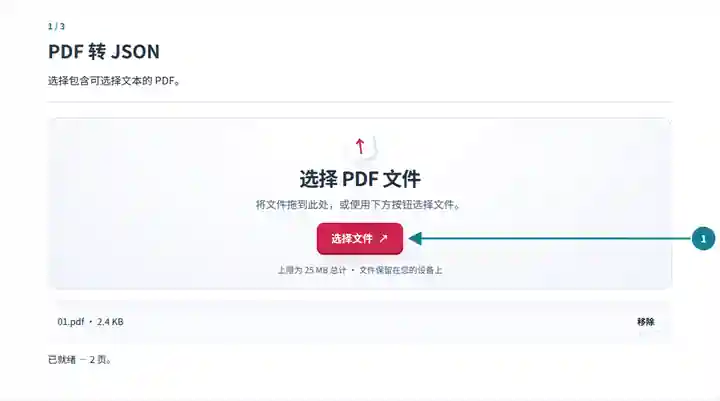
设置页面范围并查看提取限制。
点击截图可放大查看。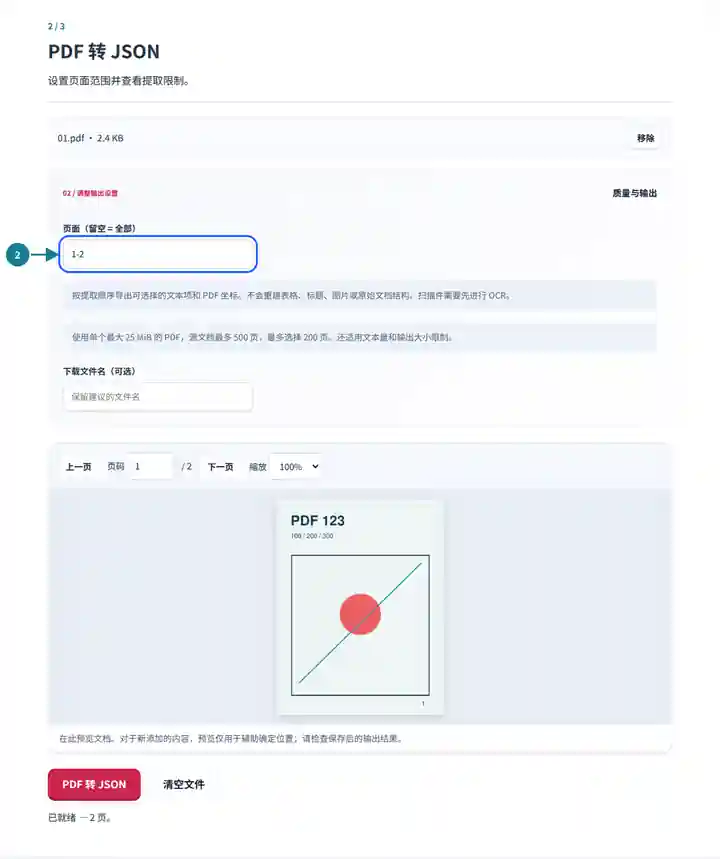
保存 JSON,并与源页面进行比较。
点击截图可放大查看。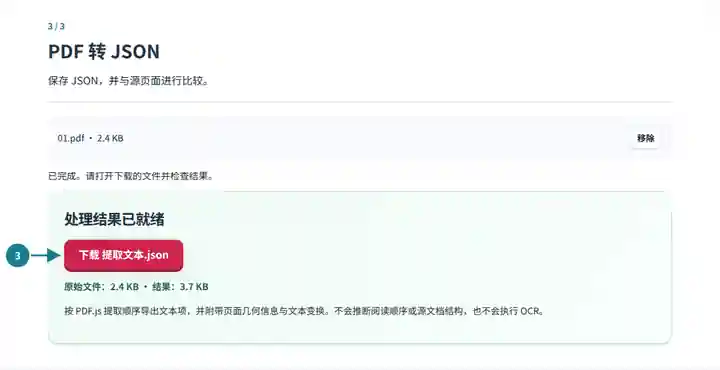
截图展示了使用不含敏感信息的示例文件操作本工具箱的过程。您的文件名、页数和设置可能不同。
当文档工作流程同时需要文本和位置信息时,JSON 很有用。开发者可以检查提取质量、查找重复标签,或准备独立的映射流程。请明确定义映射规则:附近的金额不会自动成为发票总额,提取顺序也不保证与人的阅读顺序一致。
构建解析器之前检查文本层,并保留页面引用以便调试。
采纳提取规则之前,将抽样值与源页面进行比较。
了解固定布局文档中的可见文本是如何表示的。
| 设置 | 预期结果 |
|---|---|
| 输入 | 单个 PDF,最大 25 MiB;源文档最多 500 页。 |
| 选择范围 | 最多选择 200 页;每页最多 20,000 个文本项,每次任务最多 100,000 项及 200 万个文本字符。 |
| 输出 | 包含提取文本和几何信息的 JSON;最大 64 MiB。 |
| 扫描页面 | 不执行自动 OCR、图片导出或文档字段识别。 |
对于双栏账单,请先导出一页。找到熟悉的标签,并将其位置与打印出的数值进行比较。如果两栏的文本项交错出现,应在您自己的代码中依据坐标分组,不要假设数组已经是整理好的表格。
| 情况 | 检查事项 |
|---|---|
| 找不到可选择的文本 | 对扫描页面运行 OCR,然后导出生成的 PDF 文本层。 |
| 文本顺序不符合预期 | 对照页面与文本位置;提取顺序并不等于阅读顺序。 |
| 选择范围过大而被拒绝 | 减少所选页面。内容密集的页面可能先达到文本项上限,再达到页数上限。 |
不会。结果包含文本项和几何信息。字段名称、字段关系和业务校验需要独立的映射流程。
不会导出图片。可以提取表格中的文字,但不会重建行列关系。
此导出格式用于检查,并不是 PDF 的完整表示。请保留原始 PDF,以保存外观、图形、字体和交互功能。