Seleção de páginas
Exporte um intervalo específico mantendo os números das páginas originais. Assim, fica mais fácil conferir uma amostra pequena antes de processar um documento longo.

Exporte texto selecionável, geometria de página e posições de texto como JSON.
Arraste seus arquivos para cá ou use o botão abaixo.
Até 25 MB no total · Os arquivos permanecem no seu dispositivo
Confira a prévia do documento aqui. Ao adicionar conteúdo, use-a como referência para posicioná-lo e confira o arquivo salvo.
Transforme a camada de texto de um PDF em um arquivo JSON para inspeção ou processamento posterior. A exportação registra as páginas selecionadas, suas dimensões e os itens de texto retornados pelo leitor de PDF, incluindo posições e transformações.
Um PDF armazena instruções para exibir uma página. Esta ferramenta não deduz campos de faturas, reconstrói tabelas nem identifica os níveis dos títulos originais. Páginas digitalizadas precisam de OCR antes que suas palavras possam aparecer na exportação.
Exporte um intervalo específico mantendo os números das páginas originais. Assim, fica mais fácil conferir uma amostra pequena antes de processar um documento longo.
Mantenha os itens de texto junto com a geometria da página e as informações de posicionamento. Use o PDF original para interpretar as coordenadas e verificar a relação visual entre os itens.
Baixe JSON válido para seu próprio analisador ou fluxo de revisão. O texto exportado recebe escape como dado; a ferramenta não executa o conteúdo do documento.
Leia o PDF selecionado no navegador. O documento não é enviado a um servidor de conversão e o arquivo original não é alterado.
Escolha um PDF que contenha texto selecionável.
Selecione a captura de tela para ampliá-la.
Defina o intervalo de páginas e confira os limites de extração.
Selecione a captura de tela para ampliá-la.
Salve o JSON e compare-o com a página de origem.
Selecione a captura de tela para ampliá-la.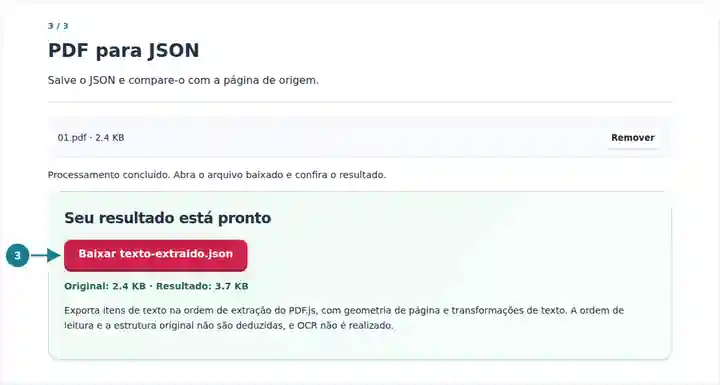
As capturas de tela mostram estas ferramentas com arquivos de exemplo sem dados sensíveis. O nome do seu arquivo, o número de páginas e as configurações podem ser diferentes.
JSON é útil quando um fluxo de documentos precisa tanto do texto quanto de sua posição. Um desenvolvedor pode inspecionar a qualidade da extração, localizar rótulos repetidos ou preparar um mapeamento separado. Esse mapeamento deve ser explícito: um valor próximo não é automaticamente o total de uma fatura, e a ordem de extração não necessariamente corresponde à ordem de leitura de uma pessoa.
Inspecione a camada de texto antes de criar um analisador e mantenha referências de página para depuração.
Compare valores de amostra com a página de origem antes de aceitar uma regra de extração.
Explore como o texto visível é representado em um documento de layout fixo.
| Configuração | O que esperar |
|---|---|
| Entrada | Um PDF de até 25 MiB, com até 500 páginas de origem. |
| Seleção | Até 200 páginas selecionadas; até 20.000 itens de texto por página, 100.000 por tarefa e dois milhões de caracteres de texto. |
| Saída | JSON contendo texto extraído e geometria; máximo de 64 MiB. |
| Páginas digitalizadas | Sem OCR automático, exportação de imagens ou reconhecimento de campos do documento. |
Para um extrato com duas colunas, exporte primeiro uma página. Localize um rótulo conhecido e compare sua posição com o valor impresso. Se itens das duas colunas estiverem intercalados, agrupe-os por coordenadas no seu código, em vez de presumir que a matriz já é uma tabela pronta.
| Situação | O que verificar |
|---|---|
| Nenhum texto selecionável é encontrado | Execute OCR nas páginas digitalizadas e exporte a camada de texto do PDF resultante. |
| O texto aparece em uma ordem inesperada | Compare a página e as posições do texto; a ordem de extração não determina a ordem de leitura. |
| Uma seleção grande é rejeitada | Escolha menos páginas. Páginas densas podem atingir o limite de itens de texto antes do limite de páginas. |
Não. O resultado contém itens de texto e geometria. Nomes de campos, relações e validação de negócio exigem um processo de mapeamento separado.
Imagens não são exportadas. O texto de uma tabela pode ser extraído, mas as relações entre linhas e colunas não são reconstruídas.
A exportação é um formato de inspeção, não uma representação completa do PDF. Mantenha o PDF original para preservar aparência, gráficos, fontes e recursos interativos.