Elementos por página
Mantenha números de páginas de origem, rotação e limites da área visível junto ao texto extraído. Isso preserva uma referência útil ao revisar um intervalo selecionado.

Extraia itens de texto e geometria de página de PDF para uma estrutura XML documentada.
Arraste seus arquivos para cá ou use o botão abaixo.
Até 25 MB no total · Os arquivos permanecem no seu dispositivo
Confira a prévia do documento aqui. Ao adicionar conteúdo, use-a como referência para posicioná-lo e confira o arquivo salvo.
Exporte a camada de texto selecionável de um PDF como XML. O arquivo agrupa os itens de texto sob seus números de página originais e registra geometria de página, direção do texto e transformações de posicionamento. Ele fornece dados estruturados para inspeção e processamento posterior.
O XML descreve o que o leitor de texto PDF extraiu. Ele não é o XML original que pode ter gerado o documento e não identifica campos de faturas, reconstrói relações de tabelas nem exporta imagens. Páginas que contêm apenas imagens precisam de OCR primeiro.
Mantenha números de páginas de origem, rotação e limites da área visível junto ao texto extraído. Isso preserva uma referência útil ao revisar um intervalo selecionado.
Caracteres como e-comercial e sinais de menor e maior permanecem como dados dentro dos elementos XML. Um texto que pareça marcação não pode virar conteúdo de página executável por meio desta exportação.
Caracteres que XML não consegue representar diretamente usam uma codificação de cadeia JSON explicitamente marcada. O marcador permite que um programa receptor recupere esses valores com precisão.
Crie o arquivo XML no seu dispositivo. O arquivo de origem não é enviado para conversão nem reescrito.
Selecione um PDF com uma camada de texto legível.
Selecione a captura de tela para ampliá-la.
Escolha as páginas necessárias para a extração XML.
Selecione a captura de tela para ampliá-la.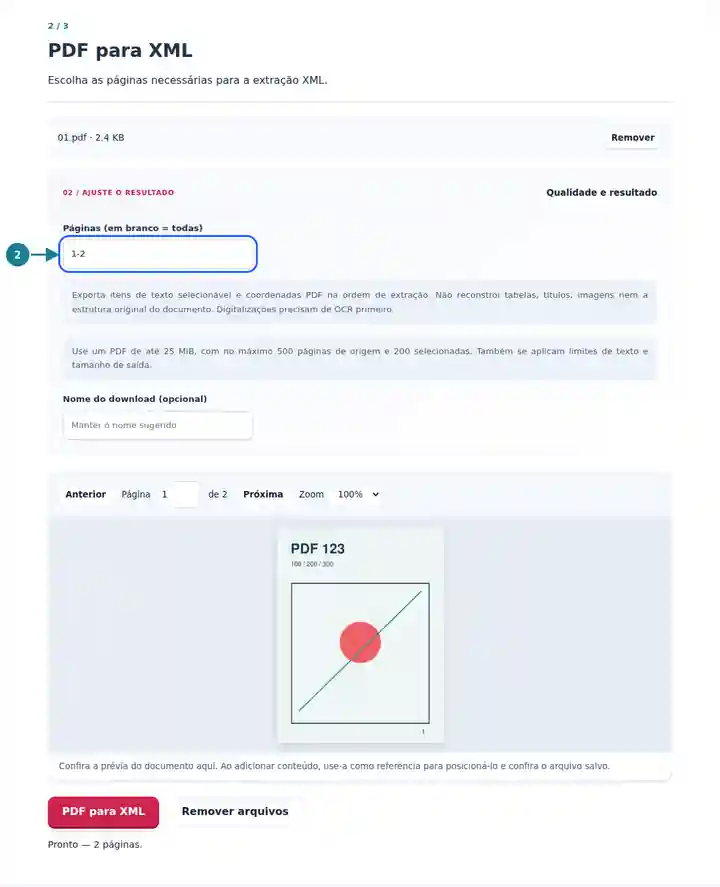
Baixe o XML e inspecione seus elementos de página.
Selecione a captura de tela para ampliá-la.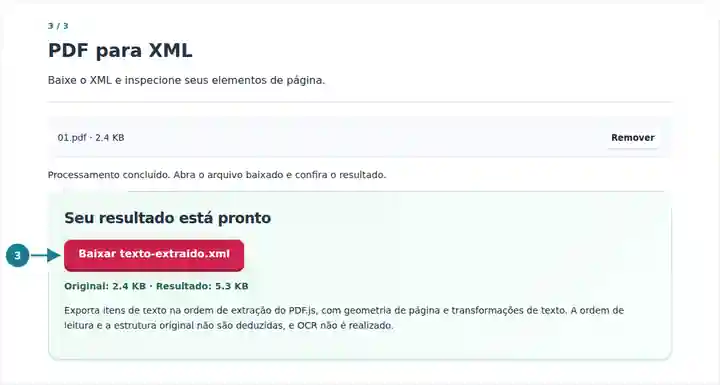
As capturas de tela mostram estas ferramentas com arquivos de exemplo sem dados sensíveis. O nome do seu arquivo, o número de páginas e as configurações podem ser diferentes.
Um fluxo baseado em XML pode precisar de elementos explícitos de página e de item antes de aplicar suas próprias regras de transformação. Uma equipe pode inspecionar esses elementos, manter referências às páginas de origem e criar um mapeamento separado para tipos de documento conhecidos. Mantenha esse mapeamento separado da extração: um item de texto próximo a outro não estabelece, por si só, uma relação de negócio.
Use elementos de página e de item como entrada de um fluxo controlado de processamento de documentos.
Verifique se o texto continua disponível junto ao PDF original preservado.
Compare valores de amostra com suas páginas de origem antes de aceitar regras de transformação.
| Configuração | O que esperar |
|---|---|
| Origem | Um PDF de até 25 MiB, com no máximo 500 páginas de origem. |
| Intervalo de páginas | Até 200 páginas selecionadas. Um intervalo em branco inclui todas as páginas apenas quando estiver dentro desse limite. |
| Limites de texto | Até 20.000 itens por página, 100.000 por tarefa e dois milhões de caracteres de texto. |
| Arquivo de saída | Um documento XML de até 64 MiB. Nenhuma DTD ou esquema externo é buscado. |
Para um documento de entrega, exporte uma página e localize um número de referência conhecido. Confira sua transformação de texto e os itens próximos com a página original. Seu aplicativo poderá aplicar uma regra para esse tipo de documento. Evite tratar todos os números próximos como o mesmo campo em layouts sem relação entre si.
| Situação | O que verificar |
|---|---|
| O XML não corresponde ao esquema de um fornecedor | A exportação usa sua própria estrutura de extração. Crie um mapeamento separado para o esquema esperado pelo sistema receptor. |
| Um elemento tem um atributo encoding | Se encoding for json, analise seu texto como uma cadeia JSON para recuperar caracteres que não podem aparecer diretamente em XML. |
| Palavras estão ausentes ou em uma ordem inesperada | Verifique se há páginas digitalizadas ou posicionamento incomum de texto. Aplique OCR quando necessário e confira as coordenadas. |
Não. Um PDF geralmente não preserva o modelo de dados de origem. Esta exportação registra a camada de texto e a geometria que o leitor consegue extrair.
Não. A ferramenta não reconstrói semântica de PDF marcado, títulos ou estrutura de tabelas. Seus elementos de página e de item descrevem resultados de extração.
A ferramenta XML para PDF pode imprimir código XML, mas não recria o layout original a partir deste arquivo de extração. Preserve o PDF original.