Elementi organizzati per pagina
Conserva numeri delle pagine di origine, rotazione e limiti dell’area visibile insieme al testo estratto. Questo mantiene un riferimento utile durante l’esame di un intervallo selezionato.

Estrai elementi di testo PDF e geometria delle pagine in una struttura XML documentata.
Trascina i file qui oppure usa il pulsante qui sotto.
Fino a 25 MB totali · I file restano sul tuo dispositivo
Visualizza il documento qui. Per il contenuto aggiunto, questa anteprima serve da guida al posizionamento; controlla il file salvato.
Esporta il livello di testo selezionabile di un PDF in XML. Il file raggruppa gli elementi di testo sotto i numeri di pagina originali e registra geometria della pagina, direzione del testo e trasformazioni di posizione. Fornisce dati strutturati da esaminare ed elaborare successivamente.
L’XML descrive ciò che il lettore del testo PDF ha estratto. Non è l’XML originale che potrebbe aver generato il documento e non identifica campi di fattura, non ricostruisce relazioni tra tabelle e non esporta immagini. Le pagine composte solo da immagini richiedono prima OCR.
Conserva numeri delle pagine di origine, rotazione e limiti dell’area visibile insieme al testo estratto. Questo mantiene un riferimento utile durante l’esame di un intervallo selezionato.
Caratteri come la e commerciale e le parentesi angolari restano dati all’interno degli elementi XML. Il testo che sembra marcatura non può diventare contenuto eseguibile della pagina attraverso questa esportazione.
I caratteri che XML non può rappresentare direttamente utilizzano una codifica di stringa JSON segnalata in modo esplicito. Il marcatore consente al programma ricevente di recuperare i valori con precisione.
Crea il file XML sul tuo dispositivo. Il sorgente non viene caricato per la conversione né riscritto.
Seleziona un PDF con un livello di testo leggibile.
Seleziona la schermata per ingrandirla.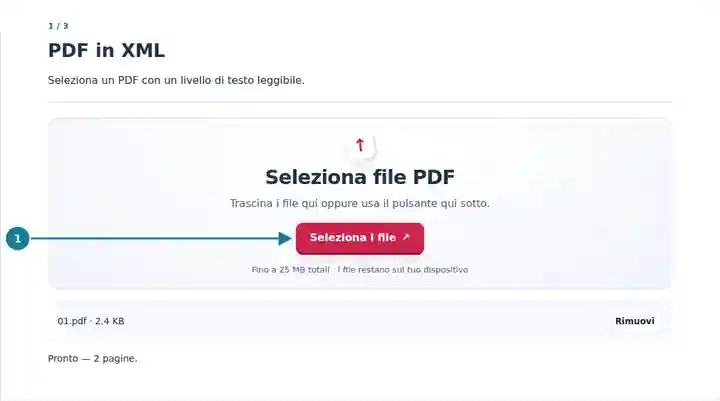
Scegli le pagine necessarie all’estrazione XML.
Seleziona la schermata per ingrandirla.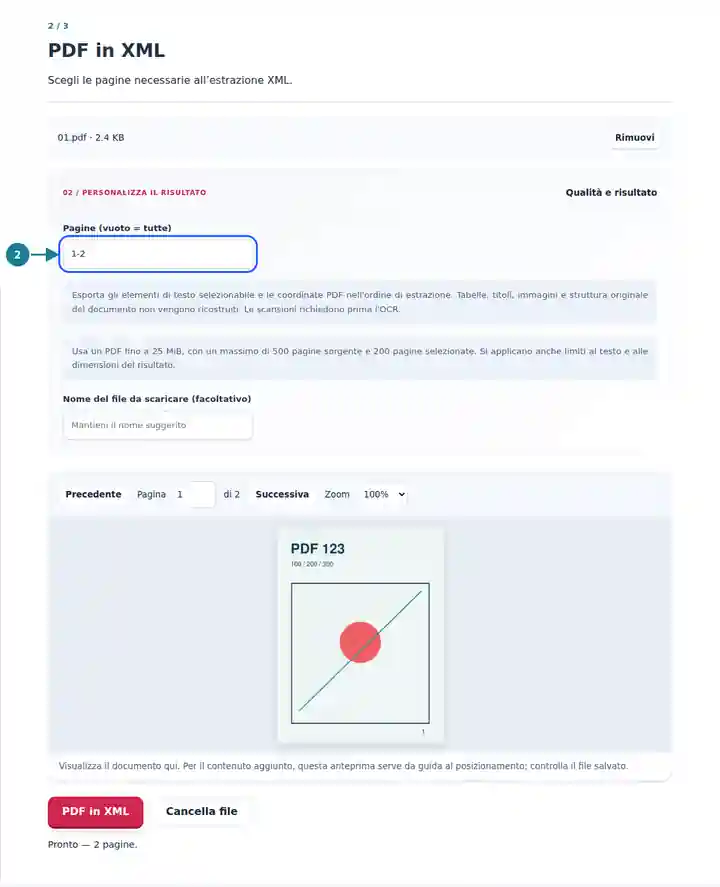
Scarica l’XML ed esamina i suoi elementi di pagina.
Seleziona la schermata per ingrandirla.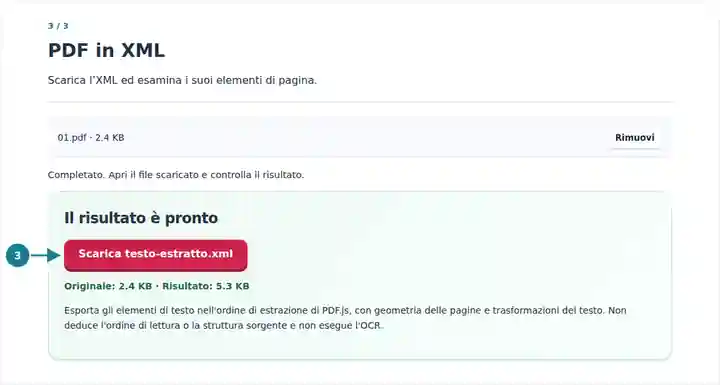
Le schermate mostrano questo toolkit con file di esempio privi di dati sensibili. Il nome del file, il numero di pagine e le impostazioni possono differire.
Un flusso basato su XML può richiedere elementi espliciti di pagina e testo prima di applicare le proprie regole di trasformazione. Un gruppo può esaminare tali elementi, conservare i riferimenti alle pagine di origine e creare una mappatura separata per tipi di documento noti. Mantieni la mappatura distinta dall’estrazione: la vicinanza tra due elementi di testo non stabilisce da sola una relazione aziendale.
Usa gli elementi di pagina e testo come ingresso per un flusso controllato di elaborazione documentale.
Verifica se il testo resta disponibile accanto al PDF originale conservato.
Confronta valori campione con le pagine di origine prima di accettare regole di trasformazione.
| Impostazione | Cosa aspettarsi |
|---|---|
| Origine | Un PDF fino a 25 MiB, con al massimo 500 pagine di origine. |
| Intervallo di pagine | Fino a 200 pagine selezionate. Un intervallo vuoto include tutte le pagine solo se rispetta questo limite. |
| Limiti del testo | Fino a 20.000 elementi per pagina, 100.000 per elaborazione e due milioni di caratteri di testo. |
| File da scaricare | Un documento XML fino a 64 MiB. Non vengono richiesti DTD o schemi esterni. |
Per un documento di consegna, esporta una pagina e trova un numero di riferimento noto. Confronta la sua trasformazione del testo e gli elementi vicini con la pagina originale. La tua applicazione potrà quindi applicare una regola per quel tipo di documento. Evita di trattare tutti i numeri vicini come lo stesso campo in impaginazioni non correlate.
| Situazione | Cosa controllare |
|---|---|
| L’XML non corrisponde allo schema di un fornitore | L’esportazione usa una propria struttura di estrazione. Crea una mappatura separata verso lo schema atteso dal sistema ricevente. |
| Un elemento ha un attributo encoding | Se encoding è json, analizza il suo testo come una stringa JSON per recuperare i caratteri che non possono apparire direttamente in XML. |
| Mancano parole o l’ordine è inatteso | Controlla se sono presenti pagine scansionate o posizionamenti insoliti del testo. Applica OCR dove serve ed esamina le coordinate. |
No. In genere un PDF non conserva il modello di dati sorgente. Questa esportazione registra il livello di testo e la geometria che il lettore può estrarre.
No. Lo strumento non ricostruisce la semantica del PDF con tag, i titoli o la struttura delle tabelle. I suoi elementi di pagina e testo descrivono i risultati di estrazione.
Lo strumento XML in PDF può stampare il sorgente XML, ma non ricrea l’impaginazione originale da questo file di estrazione. Conserva il PDF originale.