Elementy według stron
Zachowaj numery stron źródłowych, obrót i widoczne granice strony obok wyodrębnionego tekstu. Stanowi to przydatne odniesienie podczas przeglądania wybranego zakresu.

Wyodrębnij elementy tekstowe PDF i geometrię stron do udokumentowanej struktury XML.
Przeciągnij pliki tutaj lub użyj przycisku poniżej.
Do 25 MB łącznie · Pliki pozostają na Twoim urządzeniu
Tutaj zobaczysz podgląd dokumentu. Dla dodawanej treści jest to wskazówka położenia; sprawdź zapisany wynik.
Eksportuj zaznaczalną warstwę tekstową PDF jako XML. Plik grupuje elementy tekstowe według pierwotnych numerów stron oraz zapisuje geometrię stron, kierunek tekstu i przekształcenia położenia. Dostarcza uporządkowany materiał do analizy i dalszego przetwarzania.
XML opisuje to, co wyodrębnił czytnik tekstu PDF. Nie jest oryginalnym XML, z którego mógł powstać dokument, i nie identyfikuje pól faktury, nie odbudowuje relacji tabel ani nie eksportuje obrazów. Strony będące wyłącznie obrazem wymagają wcześniejszego OCR.
Zachowaj numery stron źródłowych, obrót i widoczne granice strony obok wyodrębnionego tekstu. Stanowi to przydatne odniesienie podczas przeglądania wybranego zakresu.
Znaki takie jak ampersand i nawiasy ostrokątne pozostają danymi wewnątrz elementów XML. Tekst przypominający znaczniki nie może w wyniku tego eksportu stać się wykonywalną zawartością strony.
Znaki, których XML nie może przedstawić bezpośrednio, wykorzystują wyraźnie oznaczone kodowanie ciągu JSON. Oznaczenie pozwala programowi odbierającemu dokładnie odzyskać te wartości.
Utwórz plik XML na swoim urządzeniu. Źródło nie jest przesyłane do konwersji ani zapisywane na nowo.
Wybierz PDF z czytelną warstwą tekstową.
Wybierz zrzut ekranu, aby go powiększyć.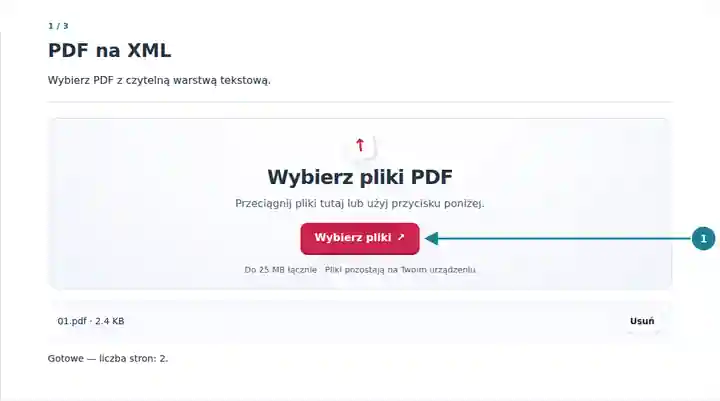
Wybierz strony potrzebne do ekstrakcji XML.
Wybierz zrzut ekranu, aby go powiększyć.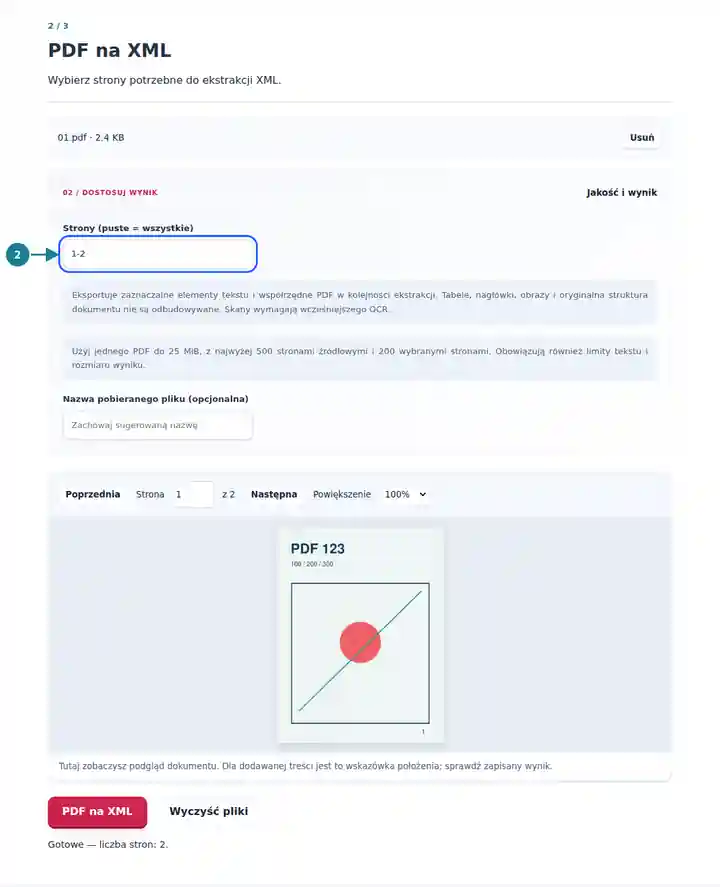
Pobierz XML i sprawdź jego elementy stron.
Wybierz zrzut ekranu, aby go powiększyć.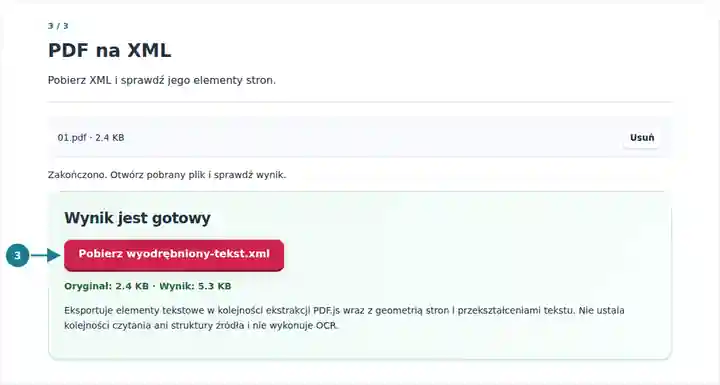
Zrzuty ekranu przedstawiają te narzędzia z nieszkodliwymi plikami przykładowymi. Nazwa Twojego pliku, liczba stron i ustawienia mogą się różnić.
Proces oparty na XML może potrzebować jawnych elementów stron i tekstu, zanim zastosuje własne reguły przekształcania. Zespół może przeanalizować te elementy, zachować odwołania do stron źródłowych i przygotować osobne mapowanie dla znanych rodzajów dokumentów. Oddziel mapowanie od ekstrakcji: sąsiedztwo dwóch elementów tekstowych samo w sobie nie ustala relacji biznesowej.
Użyj elementów stron i tekstu jako wejścia do kontrolowanego procesu przetwarzania dokumentów.
Sprawdź, czy tekst pozostaje dostępny obok zachowanego oryginalnego PDF.
Porównaj przykładowe wartości wynikowe z ich stronami źródłowymi przed zatwierdzeniem reguł przekształcania.
| Ustawienie | Oczekiwany rezultat |
|---|---|
| Źródło | Jeden PDF do 25 MiB, zawierający najwyżej 500 stron źródłowych. |
| Zakres stron | Maksymalnie 200 wybranych stron. Pusty zakres obejmuje wszystkie strony tylko wtedy, gdy mieszczą się w tym limicie. |
| Limity tekstu | Do 20 000 elementów na stronie, 100 000 na zadanie i dwóch milionów znaków tekstu. |
| Plik do pobrania | Dokument XML do 64 MiB. Nie jest pobierane zewnętrzne DTD ani schemat. |
W przypadku dokumentu dostawy wyeksportuj jedną stronę i znajdź znany numer referencyjny. Sprawdź jego przekształcenie tekstowe oraz sąsiednie elementy na tle oryginału. Aplikacja może następnie zastosować regułę dla tego typu dokumentu. Nie traktuj każdej pobliskiej liczby jako tego samego pola w niepowiązanych układach.
| Sytuacja | Co sprawdzić |
|---|---|
| XML nie pasuje do schematu dostawcy | Eksport korzysta z własnej struktury ekstrakcji. Utwórz osobne mapowanie do schematu oczekiwanego przez system odbierający. |
| Element ma atrybut encoding | Jeśli encoding ma wartość json, przeanalizuj tekst elementu jako ciąg JSON, aby odzyskać znaki niedopuszczalne bezpośrednio w XML. |
| Brakuje słów lub mają nieoczekiwaną kolejność | Sprawdź, czy strony są skanami albo tekst ma nietypowe położenie. W razie potrzeby zastosuj OCR i przejrzyj współrzędne. |
Nie. PDF na ogół nie zachowuje źródłowego modelu danych. Ten eksport zapisuje warstwę tekstową i geometrię, które czytnik potrafi wyodrębnić.
Nie. Narzędzie nie odtwarza semantyki tagowanego PDF, nagłówków ani struktury tabel. Elementy stron i tekstu opisują wyniki ekstrakcji.
Narzędzie XML na PDF może wydrukować źródło XML, ale nie odtworzy pierwotnego projektu strony z tego pliku ekstrakcji. Zachowaj oryginalny PDF.