Wybór stron
Eksportuj określony zakres stron z zachowaniem pierwotnej numeracji. Ułatwia to sprawdzenie małej próbki przed przetworzeniem dłuższego dokumentu.

Eksportuj zaznaczalny tekst, geometrię stron i położenie tekstu do JSON.
Przeciągnij pliki tutaj lub użyj przycisku poniżej.
Do 25 MB łącznie · Pliki pozostają na Twoim urządzeniu
Tutaj zobaczysz podgląd dokumentu. Dla dodawanej treści jest to wskazówka położenia; sprawdź zapisany wynik.
Zamień warstwę tekstową PDF w plik JSON do analizy lub dalszego przetwarzania. Eksport zapisuje wybrane strony, ich wymiary oraz elementy tekstowe zwrócone przez czytnik PDF, w tym ich położenie i przekształcenia.
PDF przechowuje instrukcje wyświetlania strony. To narzędzie nie rozpoznaje pól faktury, nie odbudowuje tabel ani nie ustala pierwotnych poziomów nagłówków. Strony zeskanowane wymagają wcześniejszego OCR, aby ich słowa mogły pojawić się w eksporcie.
Eksportuj określony zakres stron z zachowaniem pierwotnej numeracji. Ułatwia to sprawdzenie małej próbki przed przetworzeniem dłuższego dokumentu.
Zachowaj elementy tekstowe razem z geometrią strony i informacjami o położeniu. Odczytuj współrzędne w odniesieniu do oryginalnego PDF i sprawdzaj wizualne relacje między elementami.
Pobierz poprawny JSON do własnego parsera lub procesu weryfikacji. Eksportowany tekst jest zabezpieczany sekwencjami ucieczki jako dane; narzędzie nie wykonuje treści dokumentu.
Odczytuj wybrany PDF w przeglądarce. Dokument nie jest wysyłany na serwer konwersji, a oryginalny plik nie ulega zmianie.
Wybierz PDF zawierający zaznaczalny tekst.
Wybierz zrzut ekranu, aby go powiększyć.
Ustaw zakres stron i zapoznaj się z limitami ekstrakcji.
Wybierz zrzut ekranu, aby go powiększyć.
Zapisz JSON i porównaj go ze stroną źródłową.
Wybierz zrzut ekranu, aby go powiększyć.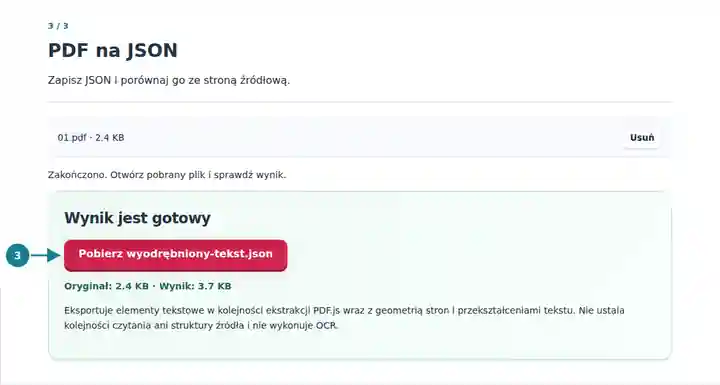
Zrzuty ekranu przedstawiają te narzędzia z nieszkodliwymi plikami przykładowymi. Nazwa Twojego pliku, liczba stron i ustawienia mogą się różnić.
JSON przydaje się, gdy przetwarzanie dokumentu wymaga zarówno tekstu, jak i jego położenia. Programista może ocenić jakość ekstrakcji, znaleźć powtarzające się etykiety lub przygotować osobny proces mapowania. Zdefiniuj to mapowanie jednoznacznie: pobliska kwota nie staje się automatycznie sumą faktury, a kolejność ekstrakcji nie musi odpowiadać kolejności czytania przez człowieka.
Sprawdź warstwę tekstową przed zbudowaniem parsera i zachowaj odwołania do stron do diagnozowania błędów.
Porównuj przykładowe wartości ze stroną źródłową przed zaakceptowaniem reguły ekstrakcji.
Sprawdź, jak widoczny tekst jest przedstawiony w dokumencie o stałym układzie.
| Ustawienie | Oczekiwany rezultat |
|---|---|
| Dane wejściowe | Jeden PDF do 25 MiB; maksymalnie 500 stron źródłowych. |
| Wybór | Maksymalnie 200 wybranych stron; 20 000 elementów tekstowych na stronę, 100 000 na zadanie i dwa miliony znaków tekstu. |
| Wynik | JSON zawierający wyodrębniony tekst i geometrię; maksymalnie 64 MiB. |
| Zeskanowane strony | Bez automatycznego OCR, eksportu obrazów ani rozpoznawania pól dokumentu. |
W przypadku dwukolumnowego zestawienia najpierw wyeksportuj jedną stronę. Znajdź znaną etykietę i porównaj jej położenie z wydrukowaną wartością. Jeśli elementy obu kolumn są przemieszane, pogrupuj je we własnym kodzie według współrzędnych, zamiast zakładać, że tablica jest już gotową tabelą.
| Sytuacja | Co sprawdzić |
|---|---|
| Nie znaleziono zaznaczalnego tekstu | Wykonaj OCR zeskanowanych stron, a następnie wyeksportuj powstałą warstwę tekstową PDF. |
| Tekst pojawia się w nieoczekiwanej kolejności | Porównaj stronę i położenie tekstu; kolejność ekstrakcji nie wyznacza kolejności czytania. |
| Duży wybór stron zostaje odrzucony | Wybierz mniej stron. Strony o gęstej zawartości mogą osiągnąć limit elementów tekstowych przed limitem stron. |
Nie. Wynik zawiera elementy tekstowe i geometrię. Nazwy pól, ich relacje i weryfikacja biznesowa wymagają osobnego procesu mapowania.
Obrazy nie są eksportowane. Tekst wewnątrz tabeli można wyodrębnić, ale relacje między wierszami i kolumnami nie są odbudowywane.
Eksport jest formatem do analizy, a nie pełną reprezentacją PDF. Zachowaj oryginał, aby przechować wygląd, grafikę, czcionki i funkcje interaktywne.