Wartości tekstowe w cudzysłowach
Zachowaj słowa takie jak yes, daty, interpunkcję i frazy z dwukropkami jako ciągi znaków. Wyodrębniony tekst nie staje się instrukcjami YAML ani niestandardowymi znacznikami obiektów.

Eksportuj elementy tekstowe PDF i ich położenie na stronach jako dane YAML.
Przeciągnij pliki tutaj lub użyj przycisku poniżej.
Do 25 MB łącznie · Pliki pozostają na Twoim urządzeniu
Tutaj zobaczysz podgląd dokumentu. Dla dodawanej treści jest to wskazówka położenia; sprawdź zapisany wynik.
Utwórz plik YAML zawierający elementy tekstowe wyodrębnione z wybranych stron PDF. Wynik obejmuje odwołania do stron źródłowych, geometrię stron i przekształcenia położenia tekstu. Nadaje się do analizy w edytorze tekstu lub do osobnego procesu przetwarzania.
Eksport nie interpretuje dokumentu jako konfiguracji aplikacji. Nie ustala poziomów nagłówków, nie wyodrębnia obrazów, nie rozpoznaje pól faktury ani nie odbudowuje tabeli na podstawie wyglądu. Tekst zachowuje kolejność ekstrakcji czytnika PDF, która może różnić się od kolejności czytania.
Zachowaj słowa takie jak yes, daty, interpunkcję i frazy z dwukropkami jako ciągi znaków. Wyodrębniony tekst nie staje się instrukcjami YAML ani niestandardowymi znacznikami obiektów.
Wybrane strony zachowują numery źródłowe. Osoby sprawdzające mogą wrócić do odpowiedniej strony PDF bez liczenia pozycji w tablicy wynikowej.
Zapisz przekształcenia tekstu, kierunek i wymiary stron wraz ze słowami. Dalszy proces może analizować położenie, zamiast zakładać istnienie gotowej tabeli.
Wynik deklaruje, że nie przeprowadzono rekonstrukcji semantycznej ani OCR. Pomaga to innemu programowi traktować rezultat jako wyodrębniony materiał źródłowy.
Wybierz PDF zawierający tekst, który chcesz sprawdzić.
Wybierz zrzut ekranu, aby go powiększyć.
Zacznij od niewielkiego zestawu stron źródłowych.
Wybierz zrzut ekranu, aby go powiększyć.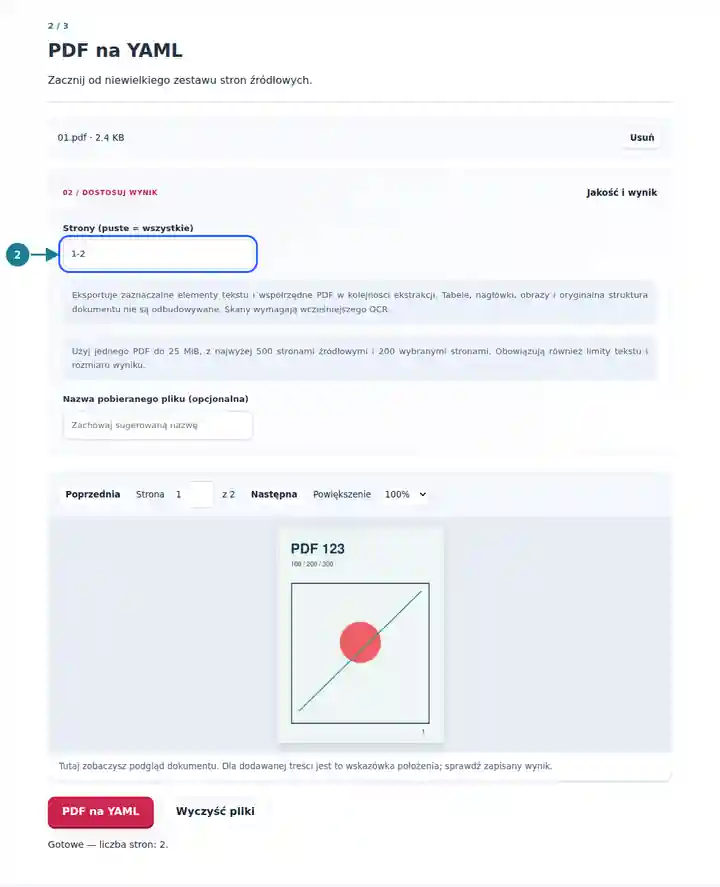
Zapisz wynik i sprawdź wartości tekstowe w cudzysłowach.
Wybierz zrzut ekranu, aby go powiększyć.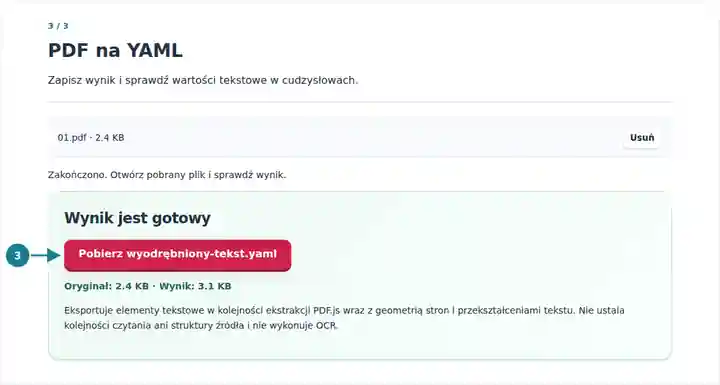
Zrzuty ekranu przedstawiają te narzędzia z nieszkodliwymi plikami przykładowymi. Nazwa Twojego pliku, liczba stron i ustawienia mogą się różnić.
YAML bywa wygodny przy przeglądzie tekstu, gdy zespół potrzebuje uporządkowanych informacji o stronach bez osobnej przeglądarki. Traktuj eksport jako dane dokumentu i zastosuj własną weryfikację przed importem. Zestawienie PDF nie powinno stawać się zaufaną konfiguracją tylko dlatego, że jego słowa zapisano w pliku YAML.
Sprawdź tekst i odwołania do stron przed zaprojektowaniem reguł ekstrakcji dla znanego układu dokumentu.
Zachowaj czytelny zapis pośredni podczas sprawdzania wybranych cytatów i ich położenia na stronach.
Porównuj zmiany w wyodrębnionych danych dokumentu narzędziami obsługującymi uporządkowane pliki tekstowe.
| Ustawienie | Oczekiwany rezultat |
|---|---|
| Plik wejściowy | Jeden PDF do 25 MiB i 500 stron źródłowych. |
| Wybrane strony | Do 200 stron w podanej kolejności; powtórzone odwołania do stron występują tylko raz. |
| Granice ekstrakcji | 20 000 elementów na stronę, 100 000 na zadanie i dwa miliony znaków tekstu. |
| Wynik YAML | Zadeklarowany YAML 1.2 z ciągami znaków w cudzysłowach; maksymalny rozmiar pobierania 64 MiB. |
Formularz może zawierać wydrukowane słowo yes obok etykiety oraz liczbę z zerami na początku. Sprawdź te wyodrębnione ciągi w YAML i porównaj ze źródłem. Eksport zachowuje tekst jako wartości w cudzysłowach, dzięki czemu Twoja aplikacja może ustalić, czy wartość jest etykietą, identyfikatorem, datą czy czymś innym.
| Sytuacja | Co sprawdzić |
|---|---|
| Tekst zawiera sekwencje ucieczki Unicode | Parser YAML może odzyskać oryginalne znaki z sekwencji w cudzysłowach. Zapobiega to również zaburzeniu struktury pliku przez znaki sterujące. |
| Wynik nie jest konfiguracją gotową do importu | To zapis ekstrakcji. Osobno zmapuj i zweryfikuj pola wymagane przez Twoją aplikację. |
| Wybrana zawartość jest zbyt gęsta | Zmniejsz zakres stron. Gęsta strona może osiągnąć limit elementów tekstowych lub znaków przed limitem stron. |
Nie. Odczytuje PDF i tworzy wynik YAML. Nie wczytuje przesłanego YAML, nie wykonuje znaczników ani nie stosuje ustawień konfiguracji.
Automatyczne OCR nie jest wykonywane. Najpierw wykonaj OCR pliku PDF zawierającego wyłącznie obrazy, a następnie sprawdź rozpoznany tekst przed eksportem.
Niekoniecznie. Strony wielokolumnowe i pozycjonowane etykiety mogą dawać inną kolejność ekstrakcji. Sprawdź ich współrzędne i oryginalną stronę.