Scalaires textuels entre guillemets
Conservez les mots comme yes, les dates, la ponctuation et les phrases avec deux-points comme valeurs de chaîne. Le texte extrait ne devient pas une instruction YAML ou une balise d’objet personnalisé.

Exportez les éléments de texte PDF et leurs positions sur les pages en données YAML.
Déposez les fichiers ici ou utilisez le bouton ci-dessous.
Jusqu’à 25 Mo au total · Les fichiers restent sur votre appareil
Visualisez le document ici. Pour le contenu ajouté, cet aperçu sert de guide de placement ; vérifiez le fichier enregistré.
Créez un fichier YAML contenant les éléments de texte extraits de pages PDF sélectionnées. Le résultat comprend les références aux pages source, la géométrie des pages et les transformations de position du texte, pour inspection dans un éditeur ou un processus distinct.
L’export n’interprète pas le document comme une configuration d’application. Il ne déduit pas les niveaux des titres, n’extrait pas les images, ne reconnaît pas les champs de facture et ne reconstitue pas un tableau d’après son apparence. Le texte suit l’ordre d’extraction du lecteur PDF, qui peut différer de l’ordre de lecture.
Conservez les mots comme yes, les dates, la ponctuation et les phrases avec deux-points comme valeurs de chaîne. Le texte extrait ne devient pas une instruction YAML ou une balise d’objet personnalisé.
Les pages sélectionnées conservent leurs numéros source. Les relecteurs peuvent revenir à la page PDF correspondante sans compter les positions dans le tableau de sortie.
Stockez les transformations et la direction du texte ainsi que les dimensions des pages avec les mots. Un traitement ultérieur peut examiner leur placement sans supposer qu’un tableau est déjà reconstitué.
Le résultat indique qu’aucune reconstitution sémantique ni aucun OCR n’a été réalisé. Cela aide un autre programme à le traiter comme des données extraites.
Choisissez un PDF contenant le texte à examiner.
Sélectionnez la capture d’écran pour l’agrandir.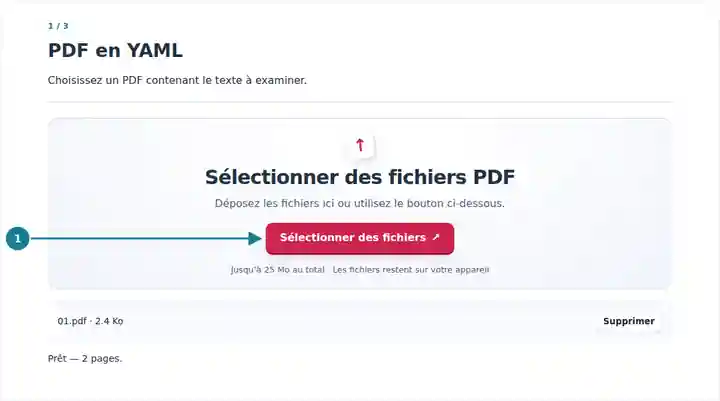
Commencez par un petit ensemble de pages source.
Sélectionnez la capture d’écran pour l’agrandir.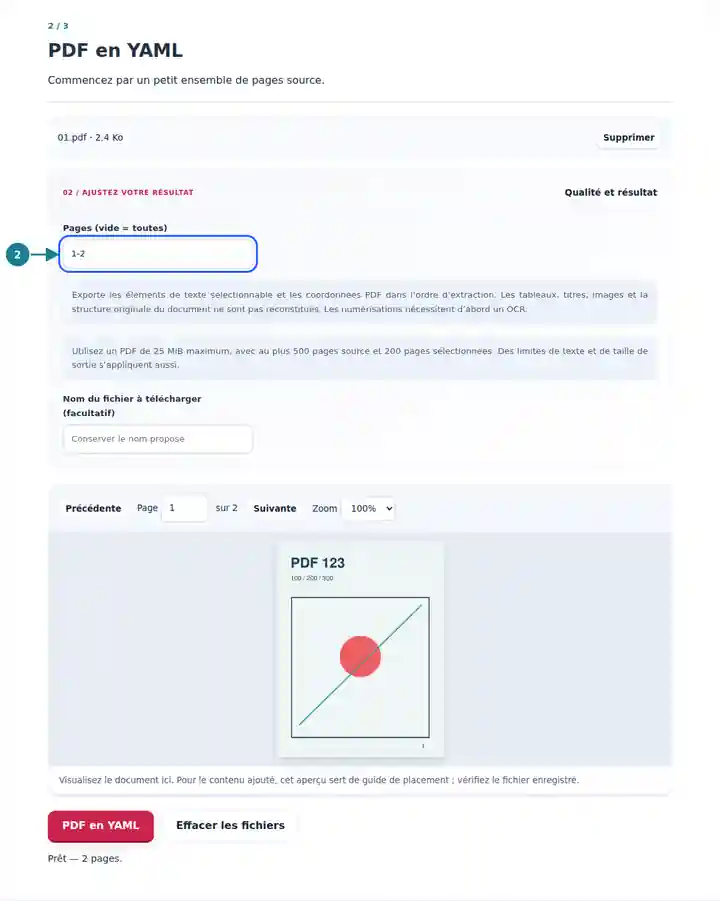
Enregistrez le résultat et examinez ses valeurs textuelles entre guillemets.
Sélectionnez la capture d’écran pour l’agrandir.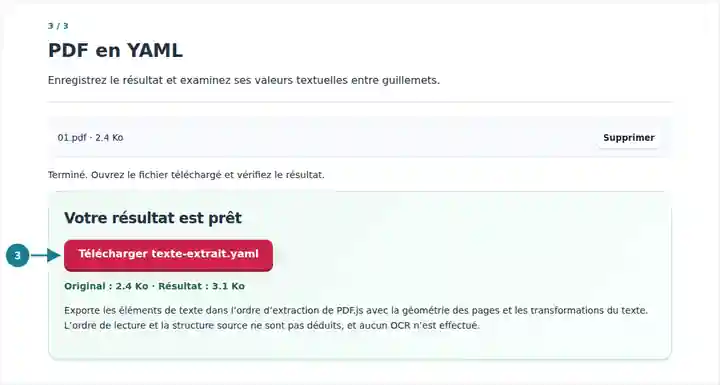
Les captures d’écran présentent cette boîte à outils avec des fichiers d’exemple sans données sensibles. Le nom de votre fichier, le nombre de pages et les réglages peuvent différer.
YAML peut être pratique pour les vérifications textuelles lorsqu’une équipe souhaite des informations de page structurées sans visualiseur distinct. Utilisez l’export comme données documentaires et appliquez votre propre validation avant de l’importer. Un relevé PDF ne doit jamais devenir une configuration de confiance simplement parce que ses mots sont stockés dans un fichier YAML.
Examinez le texte et les références de page avant de concevoir des règles d’extraction pour une présentation documentaire connue.
Conservez un relevé intermédiaire lisible pendant la vérification de citations sélectionnées et de leur emplacement dans les pages.
Comparez les modifications des données documentaires extraites avec des outils adaptés aux fichiers texte structurés.
| Réglage | Résultat attendu |
|---|---|
| Fichier d’entrée | Un PDF de 25 MiB maximum et de 500 pages source au plus. |
| Pages sélectionnées | Jusqu’à 200 pages dans l’ordre saisi ; les références répétées n’apparaissent qu’une fois. |
| Limites d’extraction | 20 000 éléments par page, 100 000 par traitement et deux millions de caractères de texte. |
| Sortie YAML | YAML 1.2 déclaré, avec valeurs de chaîne entre guillemets ; téléchargement de 64 MiB maximum. |
Un formulaire peut contenir le mot imprimé yes près d’un libellé et un nombre commençant par des zéros. Examinez ces chaînes extraites dans le YAML et comparez-les à la source. L’export conserve le texte comme valeurs entre guillemets, laissant votre application déterminer s’il s’agit d’un libellé, d’un identifiant, d’une date ou d’autre chose.
| Situation | Points à vérifier |
|---|---|
| Le texte contient des séquences Unicode | Un analyseur YAML peut retrouver les caractères d’origine à partir des séquences entre guillemets. Cela empêche aussi les caractères de contrôle de perturber la structure du fichier. |
| La sortie n’est pas une configuration prête à importer | C’est un relevé d’extraction. Associez et validez séparément les champs nécessaires à votre application. |
| La sélection est trop dense | Réduisez la plage de pages. Une page dense peut atteindre la limite d’éléments de texte ou de caractères avant la limite de pages. |
Non. Il lit un PDF et crée une sortie YAML. Il ne charge pas de YAML envoyé, n’exécute pas de balises et n’applique pas de paramètres de configuration.
Aucun OCR automatique n’est effectué. Appliquez d’abord un OCR à un PDF constitué d’images, puis examinez le texte reconnu avant de l’exporter.
Pas nécessairement. Les pages à plusieurs colonnes et les libellés positionnés peuvent donner un ordre d’extraction différent. Examinez leurs coordonnées et la page d’origine.