Escalares de texto entre comillas
Conserva palabras como yes, fechas, puntuación y frases con dos puntos como valores de cadena. El texto extraído no se convierte en instrucciones YAML ni en etiquetas de objetos personalizadas.

Exporta elementos de texto de un PDF y sus posiciones de página como datos YAML.
Arrastra aquí tus archivos o usa el botón de abajo.
Hasta 25 MB en total · Los archivos permanecen en tu dispositivo
Revisa aquí la vista previa del documento. Si añades contenido, úsala como guía para colocarlo y comprueba el archivo guardado.
Crea un archivo YAML con elementos de texto extraídos de páginas PDF seleccionadas. El resultado incluye referencias a las páginas de origen, geometría de página y transformaciones de posición del texto, por lo que sirve para revisarlo en un editor o en un proceso independiente.
La exportación no interpreta el documento como configuración de una aplicación. No puede deducir niveles de encabezado, extraer imágenes, reconocer campos de facturas ni reconstruir una tabla por su apariencia. El texto sigue el orden de extracción del lector PDF, que puede diferir del orden de lectura.
Conserva palabras como yes, fechas, puntuación y frases con dos puntos como valores de cadena. El texto extraído no se convierte en instrucciones YAML ni en etiquetas de objetos personalizadas.
Las páginas seleccionadas conservan sus números de origen. Los revisores pueden volver a la página PDF correspondiente sin contar posiciones de la matriz de salida.
Guarda las transformaciones del texto, su dirección y las dimensiones de página junto a las palabras. Un proceso posterior puede examinar la posición sin dar por hecha una tabla ya preparada.
El resultado declara que no se realizaron reconstrucción semántica ni OCR. Esto ayuda a otro programa a tratarlo como información extraída.
Elige un PDF que contenga el texto que necesitas revisar.
Selecciona la captura para ampliarla.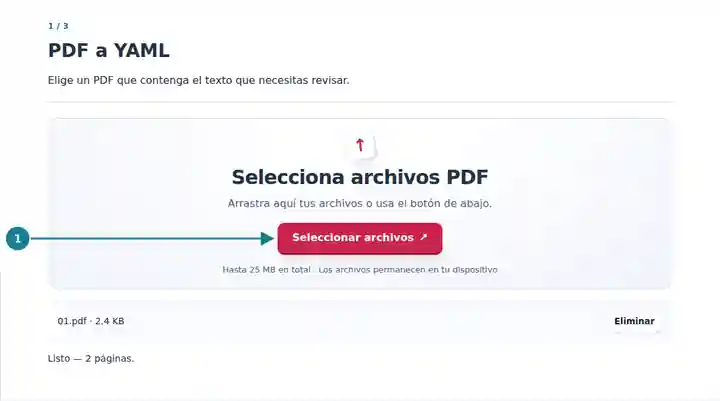
Empieza con un conjunto pequeño de páginas de origen.
Selecciona la captura para ampliarla.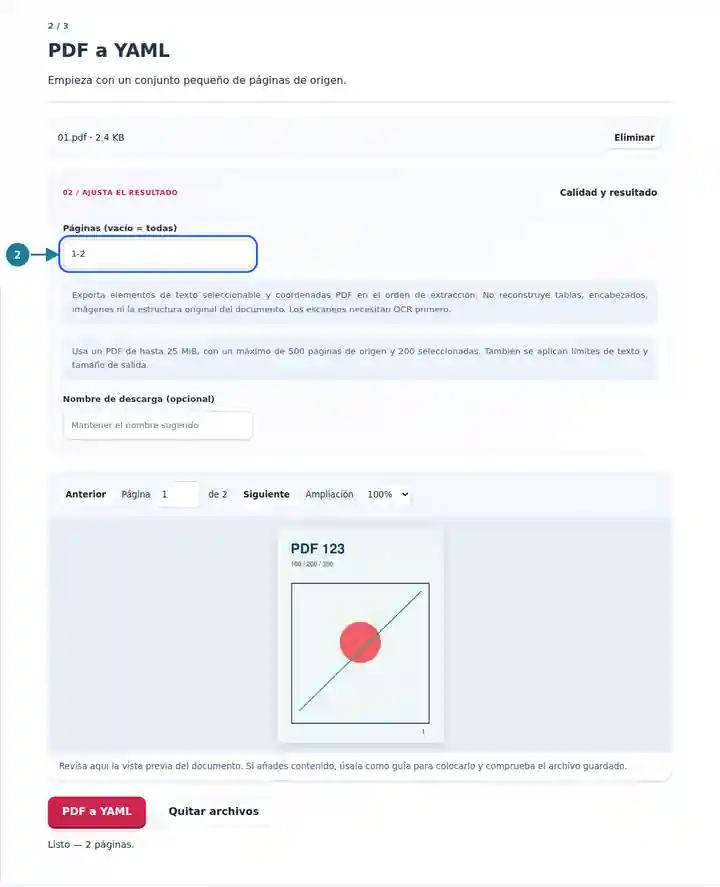
Guarda el resultado y revisa sus valores de texto entre comillas.
Selecciona la captura para ampliarla.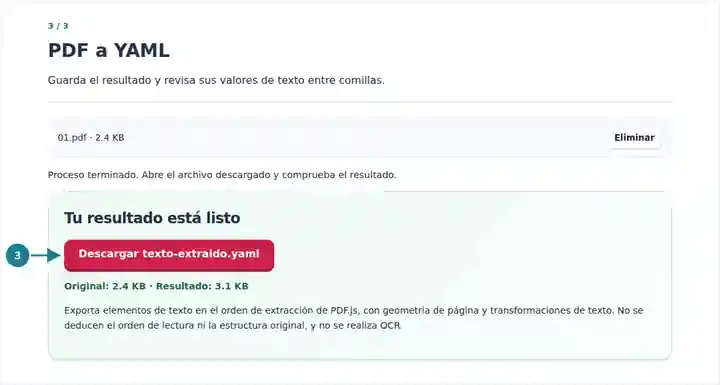
Las capturas muestran estas herramientas con archivos de ejemplo sin datos sensibles. El nombre de tu archivo, el número de páginas y los ajustes pueden ser diferentes.
YAML puede ser práctico en revisiones basadas en texto cuando un equipo quiere información estructurada de páginas sin un visor aparte. Usa la exportación como datos documentales y aplica tu propia validación antes de importarla. Un extracto PDF nunca debe convertirse en configuración de confianza simplemente porque sus palabras se guarden en un archivo YAML.
Revisa el texto y las referencias de página antes de diseñar reglas de extracción para un diseño documental conocido.
Conserva un registro intermedio legible mientras compruebas citas seleccionadas y sus ubicaciones de página.
Compara cambios en datos documentales extraídos con herramientas que gestionan archivos de texto estructurado.
| Ajuste | Qué esperar |
|---|---|
| Archivo de entrada | Un PDF de hasta 25 MiB y 500 páginas de origen. |
| Páginas seleccionadas | Hasta 200 páginas en el orden introducido; las referencias repetidas aparecen una sola vez. |
| Límites de extracción | 20.000 elementos por página, 100.000 por tarea y dos millones de caracteres de texto. |
| Resultado YAML | YAML 1.2 declarado con valores de cadena entre comillas; tamaño máximo de descarga de 64 MiB. |
Un formulario puede contener la palabra impresa yes junto a una etiqueta y un número con ceros iniciales. Revisa esas cadenas extraídas en YAML y compáralas con el documento de origen. La exportación conserva el texto como valores entre comillas, dejando que tu aplicación decida si un valor es una etiqueta, un identificador, una fecha u otra cosa.
| Situación | Qué comprobar |
|---|---|
| El texto contiene secuencias de escape Unicode | Un analizador YAML puede recuperar los caracteres originales de los escapes entre comillas. Esto también evita que los caracteres de control alteren la estructura del archivo. |
| El resultado no es una configuración lista para importar | Es un registro de extracción. Asigna y valida por separado los campos que necesita tu aplicación. |
| La selección es demasiado densa | Reduce el intervalo de páginas. Una página densa puede alcanzar el límite de elementos o caracteres de texto antes que el de páginas. |
No. Lee un PDF y crea un resultado YAML. No carga YAML subido, ejecuta etiquetas ni aplica ajustes de configuración.
No se realiza OCR automático. Aplica OCR primero a un PDF que solo contenga imágenes y después revisa el texto reconocido antes de exportarlo.
No necesariamente. Las páginas con varias columnas y las etiquetas posicionadas pueden producir otro orden de extracción. Revisa sus coordenadas y la página original.