引用符付きの文字列値
yesのような単語、日付、句読記号、コロンを含む語句を文字列値として保持します。抽出テキストがYAMLの命令や独自のオブジェクトタグになることはありません。

PDFのテキスト項目とページ内の位置をYAMLデータとして書き出します。
ここにファイルをドロップするか、下のボタンで選択してください。
最大 25 MB 合計 · ファイルは端末内に保持
ここで文書をプレビューできます。追加する内容の位置は目安です。保存した出力を確認してください。
選択したPDFページから抽出したテキスト項目を含むYAMLファイルを作成します。元のページへの参照、ページの幾何情報、テキスト位置の変換情報が入り、テキストエディターでの確認や別の処理に利用できます。
文書をアプリケーション設定として解釈するものではありません。見出し階層の推定、画像の抽出、請求書の項目の認識、見た目からの表の再構築はできません。テキストはPDFリーダーの抽出順序に従い、読む順序とは異なる場合があります。
yesのような単語、日付、句読記号、コロンを含む語句を文字列値として保持します。抽出テキストがYAMLの命令や独自のオブジェクトタグになることはありません。
選択したページは元のページ番号を保ちます。確認者は出力配列の位置を数えずに、対応するPDFページへ戻れます。
文字と一緒に、テキストの変換、方向、ページ寸法を保存します。後続処理では完成済みの表と仮定せず、配置を調べられます。
出力には、意味構造の再構築とOCRを行っていないことを明示します。別のプログラムが抽出された根拠データとして扱う際に役立ちます。
確認したいテキストを含むPDFを選びます。
スクリーンショットを選択すると拡大できます。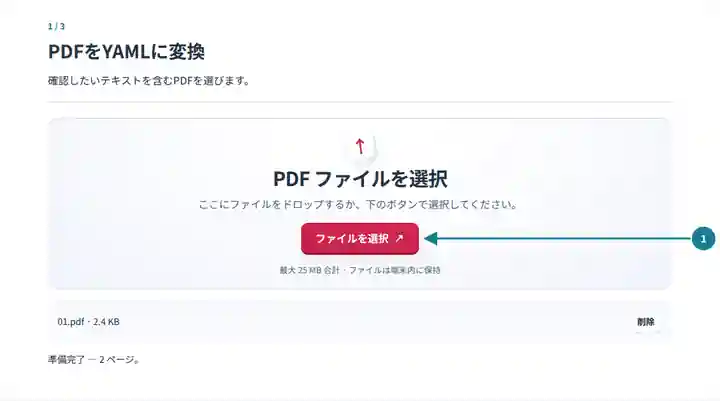
元の文書の少ないページ数から始めます。
スクリーンショットを選択すると拡大できます。
出力を保存し、引用符付きのテキスト値を確認します。
スクリーンショットを選択すると拡大できます。
スクリーンショットは、機密情報を含まないサンプルファイルでこのツールキットを操作したものです。実際のファイル名、ページ数、設定は異なる場合があります。
専用ビューアーなしで構造化されたページ情報を確認したいチームには、YAMLが便利な場合があります。出力は文書データとして使い、取り込む前に独自の検証を行ってください。PDFの明細書の文字がYAMLファイルに保存されただけで、信頼できる設定になるわけではありません。
既知の文書レイアウト用の抽出ルールを設計する前に、テキストとページ参照を確認できます。
選んだ引用文やページ上の位置を調べながら、読みやすい中間記録を保持できます。
構造化テキストファイルに対応するツールで、抽出した文書データの変更を比較できます。
| 設定 | 出力の内容 |
|---|---|
| 入力ファイル | PDFは1ファイル、最大25 MiB。元の文書は500ページまでです。 |
| 選択するページ | 入力順に最大200ページ。重複して指定したページは1回だけ含まれます。 |
| 抽出の上限 | 1ページ20,000項目、1回の処理100,000項目、テキスト200万文字までです。 |
| YAML出力 | 引用符付き文字列値を使い、YAML 1.2と宣言します。ダウンロードは最大64 MiBです。 |
フォームには、ラベルの横にyesという単語や先頭にゼロがある数字が印刷されている場合があります。YAML内の抽出文字列を確認し、元の文書と比較してください。テキストは引用符付きの値として保持されるため、ラベル、識別子、日付、その他の値のどれかは、利用者のアプリケーションで判断できます。
| 状況 | 確認する点 |
|---|---|
| テキストにUnicodeエスケープ列が含まれる | YAML解析プログラムは、引用符内のエスケープから元の文字を復元できます。制御文字がファイル構造を乱すことも防げます。 |
| そのまま取り込める設定ファイルではない | これは抽出記録です。アプリケーションに必要なフィールドの対応付けと検証は、別に行ってください。 |
| 選択した内容の密度が高すぎる | ページ範囲を減らしてください。密度の高いページは、ページ数の上限より先にテキスト項目数や文字数の上限に達する場合があります。 |
いいえ。PDFを読み込み、YAMLを書き出します。アップロードされたYAMLの読み込み、タグの実行、設定の適用は行いません。
自動OCRは行いません。画像だけのPDFには先にOCRを実行し、認識したテキストを確認してから書き出してください。
必ずしもそうではありません。複数段のページや位置指定されたラベルでは、抽出順序が異なる場合があります。座標と元のページを確認してください。