Scalari testuali tra virgolette
Conserva parole come yes, date, punteggiatura e frasi con due punti come valori di stringa. Il testo estratto non diventa istruzioni YAML o tag di oggetti personalizzati.

Esporta elementi di testo PDF e relative posizioni di pagina come dati YAML.
Trascina i file qui oppure usa il pulsante qui sotto.
Fino a 25 MB totali · I file restano sul tuo dispositivo
Visualizza il documento qui. Per il contenuto aggiunto, questa anteprima serve da guida al posizionamento; controlla il file salvato.
Crea un file YAML con elementi di testo estratti da pagine PDF selezionate. Il risultato include riferimenti alle pagine di origine, geometria delle pagine e trasformazioni della posizione del testo, per l’esame in un editor o in un flusso di elaborazione separato.
L’esportazione non interpreta il documento come configurazione di un’applicazione. Non deduce livelli dei titoli, estrae figure, riconosce campi di fattura o ricostruisce una tabella dal suo aspetto. Il testo segue l’ordine di estrazione del lettore PDF, che può differire dall’ordine di lettura.
Conserva parole come yes, date, punteggiatura e frasi con due punti come valori di stringa. Il testo estratto non diventa istruzioni YAML o tag di oggetti personalizzati.
Le pagine selezionate conservano i numeri di origine. I revisori possono tornare alla pagina PDF corrispondente senza contare le posizioni nell’array di uscita.
Memorizza trasformazioni e direzione del testo, oltre alle dimensioni delle pagine, insieme alle parole. Un processo successivo può esaminare la disposizione senza presumere che esista già una tabella pronta.
L’uscita dichiara che non sono stati effettuati ricostruzione semantica e OCR. Ciò aiuta un altro programma a trattare il risultato come dati estratti.
Scegli un PDF contenente il testo che vuoi esaminare.
Seleziona la schermata per ingrandirla.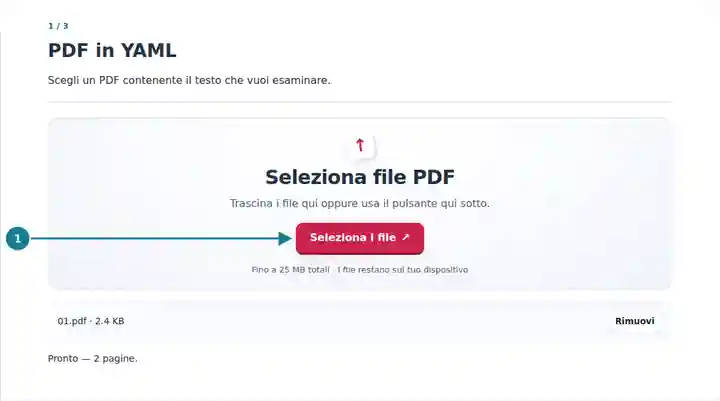
Inizia con un piccolo gruppo di pagine di origine.
Seleziona la schermata per ingrandirla.
Salva il risultato ed esamina i valori testuali tra virgolette.
Seleziona la schermata per ingrandirla.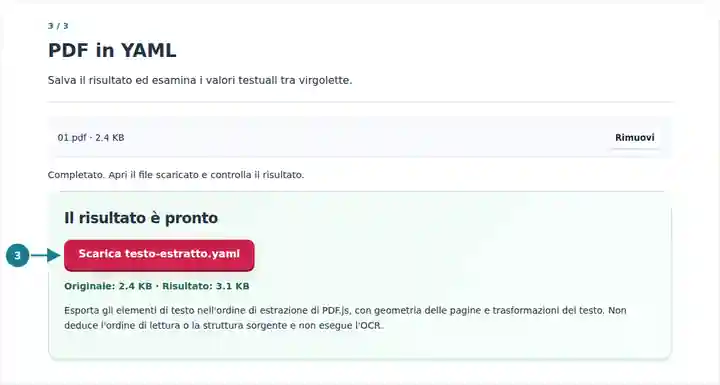
Le schermate mostrano questo toolkit con file di esempio privi di dati sensibili. Il nome del file, il numero di pagine e le impostazioni possono differire.
YAML può essere comodo per revisioni testuali quando un gruppo desidera informazioni strutturate sulle pagine senza un visualizzatore separato. Usa l’esportazione come dati documentali e applica la tua validazione prima dell’importazione. Un prospetto PDF non deve diventare una configurazione attendibile soltanto perché le sue parole sono memorizzate in un file YAML.
Esamina testo e riferimenti di pagina prima di progettare regole di estrazione per un’impaginazione nota.
Conserva un resoconto intermedio leggibile mentre controlli citazioni selezionate e le loro posizioni nelle pagine.
Confronta le modifiche nei dati documentali estratti con strumenti che gestiscono file di testo strutturato.
| Impostazione | Cosa aspettarsi |
|---|---|
| File di ingresso | Un PDF fino a 25 MiB e 500 pagine di origine. |
| Pagine selezionate | Fino a 200 pagine nell’ordine inserito; i riferimenti ripetuti compaiono una volta. |
| Limiti di estrazione | 20.000 elementi per pagina, 100.000 per elaborazione e due milioni di caratteri di testo. |
| Uscita YAML | YAML 1.2 dichiarato con valori di stringa tra virgolette; download massimo di 64 MiB. |
Un modulo può contenere la parola stampata yes accanto a un’etichetta e un numero con zeri iniziali. Esamina queste stringhe estratte nel YAML e confrontale con il sorgente. L’esportazione conserva il testo come valori tra virgolette, lasciando alla tua applicazione la decisione se un valore sia un’etichetta, un identificatore, una data o altro.
| Situazione | Cosa controllare |
|---|---|
| Il testo contiene sequenze Unicode | Un analizzatore YAML può recuperare i caratteri originali dalle sequenze tra virgolette. Questo impedisce inoltre ai caratteri di controllo di alterare la struttura del file. |
| Il risultato non è una configurazione pronta da importare | È un resoconto di estrazione. Associa e valida separatamente i campi richiesti dalla tua applicazione. |
| La selezione è troppo densa | Riduci l’intervallo di pagine. Una pagina densa può raggiungere il limite degli elementi di testo o dei caratteri prima di quello delle pagine. |
No. Legge un PDF e crea un risultato YAML. Non carica YAML inviato, non esegue tag e non applica impostazioni di configurazione.
Non viene effettuato OCR automatico. Esegui prima OCR su un PDF composto da immagini, quindi esamina il testo riconosciuto prima di esportarlo.
Non necessariamente. Le pagine a più colonne e le etichette posizionate possono produrre un ordine di estrazione diverso. Controlla le coordinate e la pagina originale.