Текстовые скаляры в кавычках
Сохраните слова вроде yes, даты, пунктуацию и фразы с двоеточиями как строковые значения. Извлечённый текст не превращается в инструкции YAML или теги пользовательских объектов.

Экспортируйте текстовые элементы PDF и их положения на страницах в YAML.
Перетащите файлы сюда или используйте кнопку ниже.
До 25 МБ всего · Файлы остаются на вашем устройстве
Просмотрите документ здесь. При добавлении содержимого используйте предварительный просмотр для размещения элементов и проверьте сохранённый результат.
Создайте файл YAML с текстовыми элементами, извлечёнными из выбранных страниц PDF. Результат включает ссылки на исходные страницы, геометрию страниц и преобразования положения текста, поэтому подходит для проверки в текстовом редакторе или отдельном процессе обработки.
Экспорт не интерпретирует документ как конфигурацию приложения. Он не определяет уровни заголовков, не извлекает изображения, не распознаёт поля счетов и не восстанавливает таблицу по её виду. Текст следует порядку извлечения средства чтения PDF, который может отличаться от порядка чтения.
Сохраните слова вроде yes, даты, пунктуацию и фразы с двоеточиями как строковые значения. Извлечённый текст не превращается в инструкции YAML или теги пользовательских объектов.
Выбранные страницы сохраняют исходные номера. Проверяющий может вернуться к нужной странице PDF, не отсчитывая позиции в выходном массиве.
Сохраните преобразования, направление текста и размеры страниц вместе со словами. Последующая обработка сможет изучить размещение, не предполагая наличие готовой таблицы.
В результате указано, что семантическое восстановление и OCR не выполнялись. Это помогает другой программе считать результат извлечёнными данными.
Выберите PDF с текстом, который нужно проверить.
Нажмите на снимок экрана, чтобы увеличить его.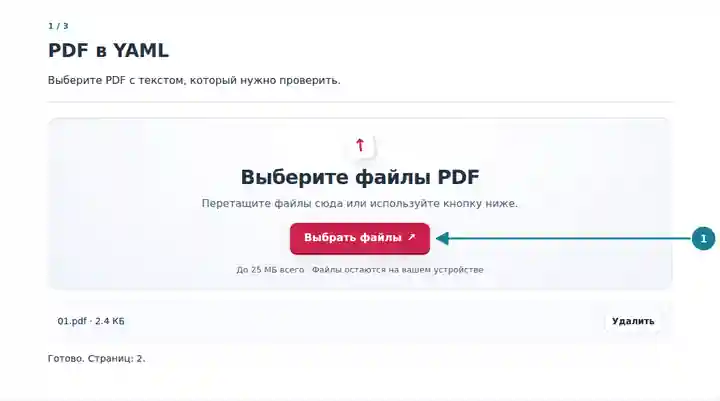
Начните с небольшого набора исходных страниц.
Нажмите на снимок экрана, чтобы увеличить его.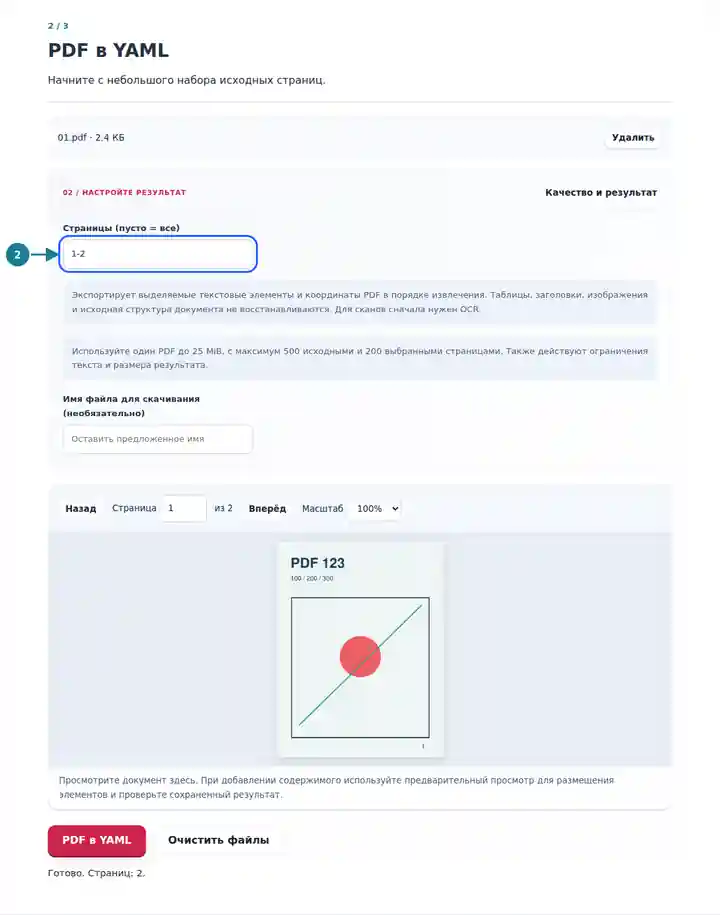
Сохраните результат и проверьте текстовые значения в кавычках.
Нажмите на снимок экрана, чтобы увеличить его.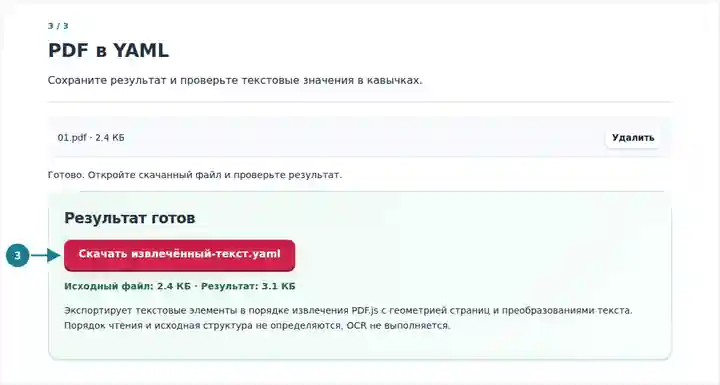
Снимки экрана показывают этот набор инструментов с безопасными примерными файлами. Имя вашего файла, количество страниц и настройки могут отличаться.
YAML удобен для текстовых проверок, когда команде нужна структурированная информация о страницах без отдельного просмотрщика. Используйте экспорт как данные документа и проводите собственную проверку перед импортом. Выписка PDF не должна становиться доверенной конфигурацией только потому, что её слова сохранены в файле YAML.
Проверьте текст и ссылки на страницы перед созданием правил извлечения для известного макета документа.
Сохраните читаемый промежуточный результат при проверке выбранных цитат и их расположения на страницах.
Сравнивайте изменения извлечённых данных документа инструментами, работающими со структурированными текстовыми файлами.
| Настройка | Что ожидать |
|---|---|
| Входной файл | Один PDF до 25 MiB и 500 исходных страниц. |
| Выбранные страницы | До 200 страниц в указанном порядке; повторные ссылки на страницы появляются один раз. |
| Границы извлечения | 20 000 элементов на страницу, 100 000 за обработку и два миллиона символов текста. |
| Результат YAML | Явно объявленный YAML 1.2 со строковыми значениями в кавычках; максимальный размер скачивания 64 MiB. |
В форме рядом с подписью может быть напечатано слово yes и число с начальными нулями. Проверьте извлечённые строки в YAML и сравните с источником. Экспорт сохраняет текст как значения в кавычках, позволяя вашему приложению определить, является ли значение подписью, идентификатором, датой или чем-то другим.
| Ситуация | Что проверить |
|---|---|
| Текст содержит escape-последовательности Unicode | Анализатор YAML может восстановить исходные символы из экранирования внутри кавычек. Это также не позволяет управляющим символам нарушить структуру файла. |
| Результат не является готовой к импорту конфигурацией | Это запись извлечения. Отдельно сопоставьте и проверьте поля, необходимые вашему приложению. |
| Выбранные страницы слишком плотные | Уменьшите диапазон. Плотная страница может достичь ограничения элементов или символов текста раньше ограничения страниц. |
Нет. Он читает PDF и создаёт YAML. Он не загружает переданный YAML, не выполняет теги и не применяет параметры конфигурации.
Автоматический OCR не выполняется. Сначала примените OCR к PDF, состоящему из изображений, затем проверьте распознанный текст перед экспортом.
Не обязательно. Многоколоночные страницы и размещённые вручную подписи могут давать другой порядок извлечения. Проверьте координаты и исходную страницу.