ページの選択
元のページ番号を保持して、指定したページ範囲を書き出せます。長い文書を処理する前に、小さなサンプルを確認しやすくなります。

選択可能なテキスト、ページの幾何情報、テキスト位置をJSONとして書き出します。
ここにファイルをドロップするか、下のボタンで選択してください。
最大 25 MB 合計 · ファイルは端末内に保持
ここで文書をプレビューできます。追加する内容の位置は目安です。保存した出力を確認してください。
PDFのテキスト層を、確認や後続処理に使えるJSONファイルに変換します。選択したページ、その寸法、PDFリーダーが返すテキスト項目を、位置や変換情報とともに記録します。
PDFはページを表示するための命令を保存しています。このツールは請求書の項目を推定したり、表を再構築したり、元の見出し階層を判定したりしません。スキャンページの文字を書き出すには、先にOCRによる文字認識が必要です。
元のページ番号を保持して、指定したページ範囲を書き出せます。長い文書を処理する前に、小さなサンプルを確認しやすくなります。
テキスト項目をページの幾何情報や配置情報とともに保持します。座標の意味を読み取り、項目同士の見た目上の関係を確かめる際は、元のPDFを参照してください。
独自の解析プログラムや確認作業で使える有効なJSONをダウンロードできます。書き出されるテキストはデータとしてエスケープされ、文書の内容が実行されることはありません。
選択したPDFをブラウザーで読み取ります。文書は変換サーバーに送信されず、元のファイルも変更されません。
選択可能なテキストを含むPDFを選びます。
スクリーンショットを選択すると拡大できます。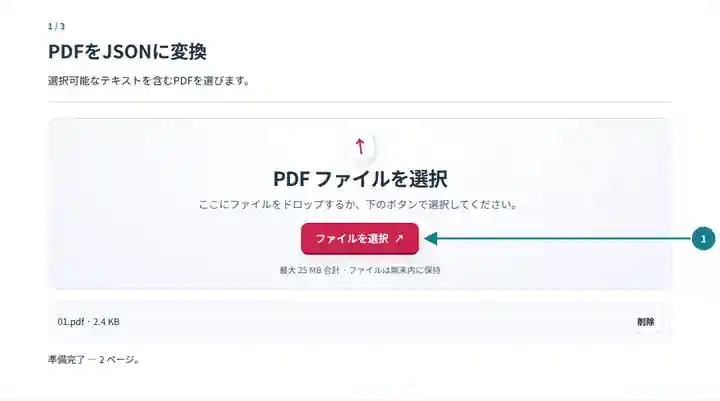
ページ範囲を指定し、抽出の制限を確認します。
スクリーンショットを選択すると拡大できます。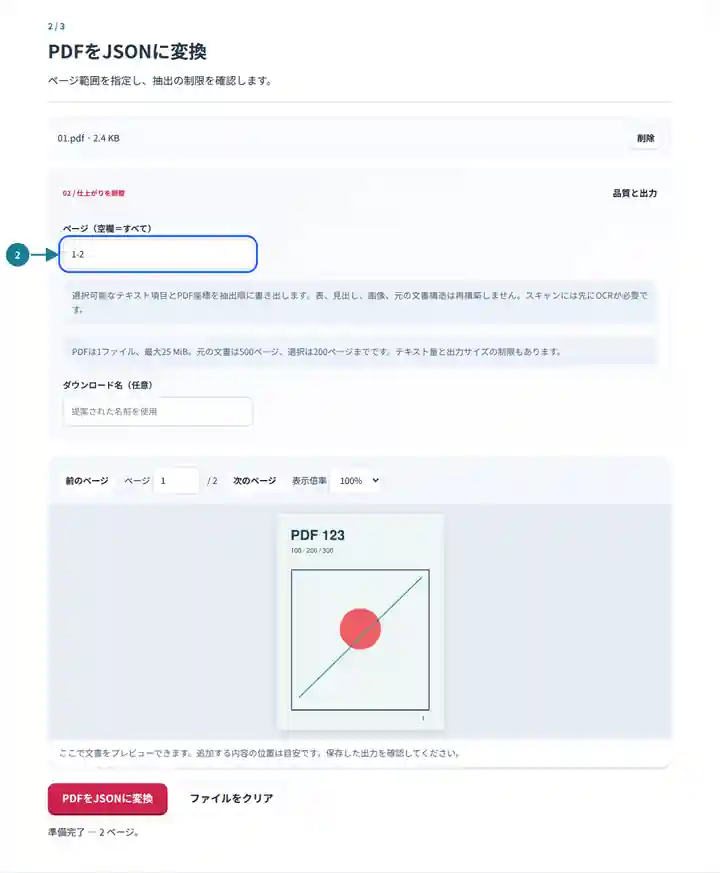
JSONを保存し、元のページと比較します。
スクリーンショットを選択すると拡大できます。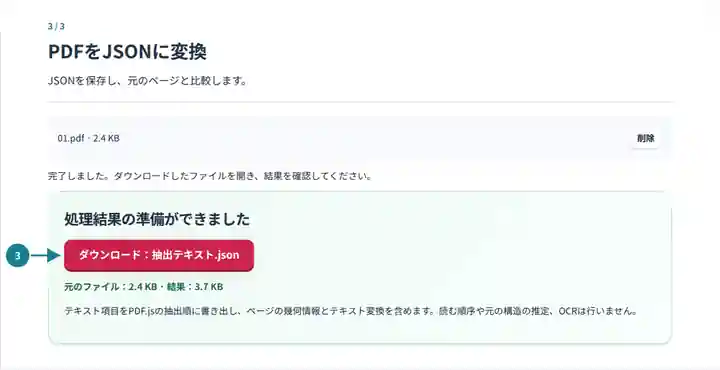
スクリーンショットは、機密情報を含まないサンプルファイルでこのツールキットを操作したものです。実際のファイル名、ページ数、設定は異なる場合があります。
文書処理でテキストと位置の両方が必要な場合に、JSONが役立ちます。開発者は抽出品質を調べたり、繰り返し現れるラベルを探したり、別の対応付け処理を準備したりできます。その対応付けは明確に定義してください。近くにある金額が自動的に請求総額になるわけではなく、抽出順序が人の読む順序に一致する保証もありません。
解析プログラムを作る前にテキスト層を確認し、デバッグ用にページ参照を保持できます。
抽出ルールを採用する前に、値のサンプルを元のページと比較できます。
固定レイアウトの文書内で、見える文字がどのように表現されているかを調べられます。
| 設定 | 出力の内容 |
|---|---|
| 入力 | PDFは1ファイル、最大25 MiB。元の文書は最大500ページです。 |
| 選択範囲 | 選択は最大200ページ。テキスト項目は1ページ20,000件、1回の処理100,000件、テキストは200万文字までです。 |
| 出力 | 抽出したテキストと幾何情報を含むJSON。最大64 MiBです。 |
| スキャンページ | 自動OCR、画像の書き出し、文書フィールドの認識は行いません。 |
2段組の明細書では、まず1ページを書き出してください。見慣れたラベルを見つけ、位置を印字された値と比べます。両方の段の項目が入り交じる場合は、配列が完成済みの表だと考えず、独自のコードで座標を使ってグループ化してください。
| 状況 | 確認する点 |
|---|---|
| 選択可能なテキストが見つからない | スキャンページにOCRを実行し、生成されたPDFのテキスト層を書き出してください。 |
| テキストの順序が想定と異なる | ページとテキスト位置を比較してください。抽出順序が読む順序を示すとは限りません。 |
| 広い範囲を選ぶと拒否される | ページ数を減らしてください。密度の高いページは、ページ数の上限より先にテキスト項目の上限に達する場合があります。 |
いいえ。結果に含まれるのはテキスト項目と幾何情報です。フィールド名や関係の判定、業務上の検証には、別の対応付け処理が必要です。
画像は書き出されません。表内のテキストは抽出できますが、行と列の関係は再構築されません。
この出力は確認用の形式であり、PDFの完全な表現ではありません。見た目、図形、フォント、対話機能を保持するため、元のPDFを保存してください。