ページごとの要素
元のページ番号、回転、見えるページ範囲を、抽出テキストと一緒に保持します。選択した範囲を確認するときの参照になります。

PDFのテキスト項目とページの幾何情報を、仕様が明示されたXML構造に抽出します。
ここにファイルをドロップするか、下のボタンで選択してください。
最大 25 MB 合計 · ファイルは端末内に保持
ここで文書をプレビューできます。追加する内容の位置は目安です。保存した出力を確認してください。
PDFの選択可能なテキスト層をXMLとして書き出します。元のページ番号ごとにテキスト項目をまとめ、ページの幾何情報、テキスト方向、位置の変換情報を記録します。確認や後続処理に使える構造化された根拠データになります。
XMLが表すのは、PDFのテキストリーダーが抽出した内容です。文書の作成に使われた可能性がある元のXMLではなく、請求書の項目の識別、表の関係の再構築、画像の書き出しも行いません。画像だけのページには先にOCRが必要です。
元のページ番号、回転、見えるページ範囲を、抽出テキストと一緒に保持します。選択した範囲を確認するときの参照になります。
アンパサンドや山括弧などは、XML要素内のデータとして保持されます。マークアップに見える文字列が、この書き出しによって実行可能なページ内容になることはありません。
XMLで直接表せない文字には、明示的な印を付けたJSON文字列エンコードを使います。受信側プログラムはこの印に従い、値を正確に復元できます。
お使いの端末でXMLファイルを作成します。元のファイルは変換用にアップロードされず、書き換えられません。
読み取り可能なテキスト層を持つPDFを選びます。
スクリーンショットを選択すると拡大できます。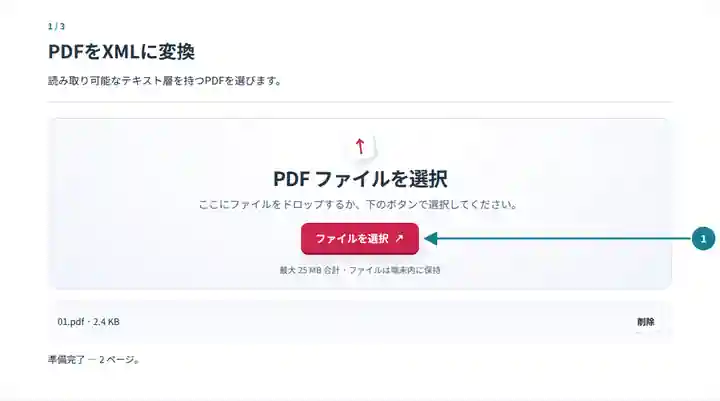
XML抽出に必要なページを選びます。
スクリーンショットを選択すると拡大できます。
XMLをダウンロードし、ページ要素を確認します。
スクリーンショットを選択すると拡大できます。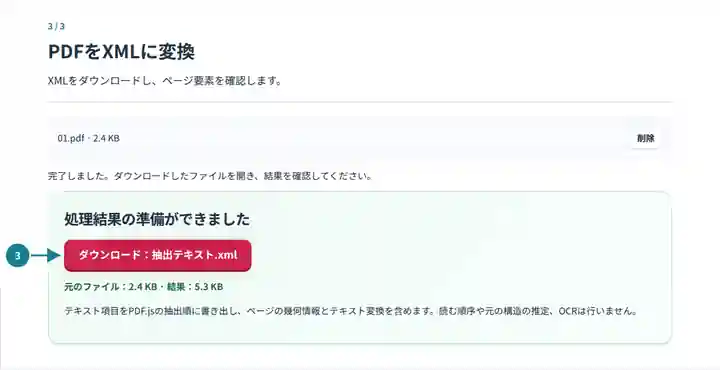
スクリーンショットは、機密情報を含まないサンプルファイルでこのツールキットを操作したものです。実際のファイル名、ページ数、設定は異なる場合があります。
XMLを使う処理では、独自の変換規則を適用する前に、明確なページ要素と項目要素が必要な場合があります。チームはこれらを確認し、元のページへの参照を保持して、既知の文書種類に対する別の対応付けを作れます。対応付けと抽出は区別してください。テキスト項目が近くにあるだけでは、業務上の関係は確定しません。
管理された文書処理の入力として、ページ要素と項目要素を使えます。
保管している元のPDFとあわせて、テキストが利用可能な状態かを確認できます。
変換規則を採用する前に、出力値のサンプルを元のページと比較できます。
| 設定 | 出力の内容 |
|---|---|
| 元のファイル | PDFは1ファイル、最大25 MiB。元の文書は500ページ以内です。 |
| ページ範囲 | 最大200ページを選択できます。範囲を空欄にして全ページを含められるのは、この上限内の場合だけです。 |
| テキストの制限 | 1ページ20,000項目、1回の処理100,000項目、テキスト200万文字までです。 |
| ダウンロード | 最大64 MiBのXML文書。外部のDTDやスキーマは取得しません。 |
納品書では、まず1ページを書き出して見慣れた参照番号を探します。そのテキスト変換と近くの項目を、元のページと比較してください。その後、アプリケーション側でその文書種類のルールを適用できます。無関係なレイアウトで、近くの数字をすべて同じフィールドと見なさないようにしてください。
| 状況 | 確認する点 |
|---|---|
| 取引先のスキーマとXMLが一致しない | 出力には独自の抽出構造を使います。受信システムが求めるスキーマへの対応付けを別に作成してください。 |
| 要素にencoding属性がある | encodingがjsonの場合、そのテキストをJSON文字列として解析すると、XMLに直接記述できない文字を復元できます。 |
| 文字が欠ける、または順序が想定と異なる | スキャンページや特殊なテキスト配置がないか確認してください。必要に応じてOCRを実行し、座標を調べてください。 |
いいえ。通常、PDFには元のデータモデルは残りません。この出力が記録するのは、リーダーが抽出できるテキスト層と幾何情報です。
いいえ。タグ付きPDFの意味構造、見出し、表の構造は再構築しません。ページ要素と項目要素は抽出結果を記述します。
XMLからPDFへの変換ツールはXMLソースを印刷できますが、この抽出ファイルから元のページデザインを再現することはできません。元のPDFを保持してください。