Elemen berdasarkan halaman
Pertahankan nomor halaman sumber, rotasi, dan batas area halaman yang terlihat bersama teks hasil ekstraksi. Ini mempertahankan rujukan yang berguna saat meninjau rentang terpilih.

Ekstrak elemen teks PDF dan geometri halaman ke struktur XML yang terdokumentasi.
Seret berkas Anda ke sini atau gunakan tombol di bawah.
Hingga 25 MB total · Berkas tetap di perangkat Anda
Lihat pratinjau dokumen di sini. Saat menambahkan isi, gunakan pratinjau sebagai panduan penempatan dan periksa berkas yang disimpan.
Ekspor lapisan teks PDF yang dapat dipilih sebagai XML. Berkas mengelompokkan elemen teks berdasarkan nomor halaman asli dan mencatat geometri halaman, arah teks, serta transformasi posisi. Hasilnya menyediakan data terstruktur untuk diperiksa dan diproses kemudian.
XML menjelaskan apa yang diekstrak oleh pembaca teks PDF. Hasil tersebut bukan XML asli yang mungkin digunakan untuk membuat dokumen dan tidak mengenali bidang faktur, menyusun ulang hubungan tabel, atau mengekspor gambar. Halaman yang hanya berisi gambar memerlukan OCR terlebih dahulu.
Pertahankan nomor halaman sumber, rotasi, dan batas area halaman yang terlihat bersama teks hasil ekstraksi. Ini mempertahankan rujukan yang berguna saat meninjau rentang terpilih.
Karakter seperti ampersand dan tanda kurung sudut tetap menjadi data di dalam elemen XML. Teks yang menyerupai markah tidak dapat menjadi isi halaman yang dapat dieksekusi melalui ekspor ini.
Karakter yang tidak dapat direpresentasikan XML secara langsung menggunakan pengodean untai JSON dengan penanda eksplisit. Penanda itu memungkinkan program penerima memulihkan nilainya dengan tepat.
Buat berkas XML pada perangkat Anda. Sumber tidak diunggah untuk konversi maupun ditulis ulang.
Pilih PDF dengan lapisan teks yang dapat dibaca.
Pilih tangkapan layar untuk memperbesarnya.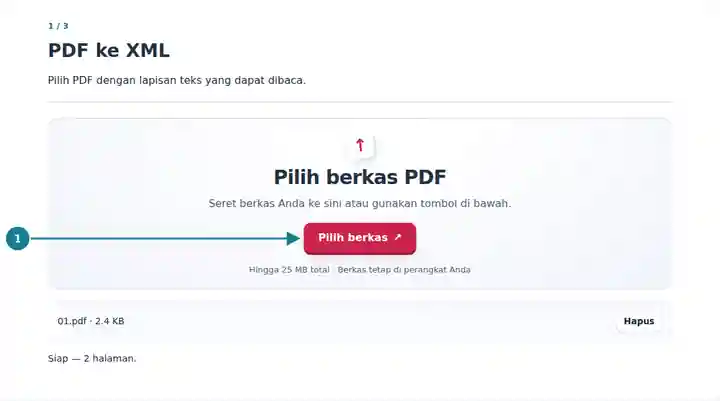
Pilih halaman yang diperlukan untuk ekstraksi XML.
Pilih tangkapan layar untuk memperbesarnya.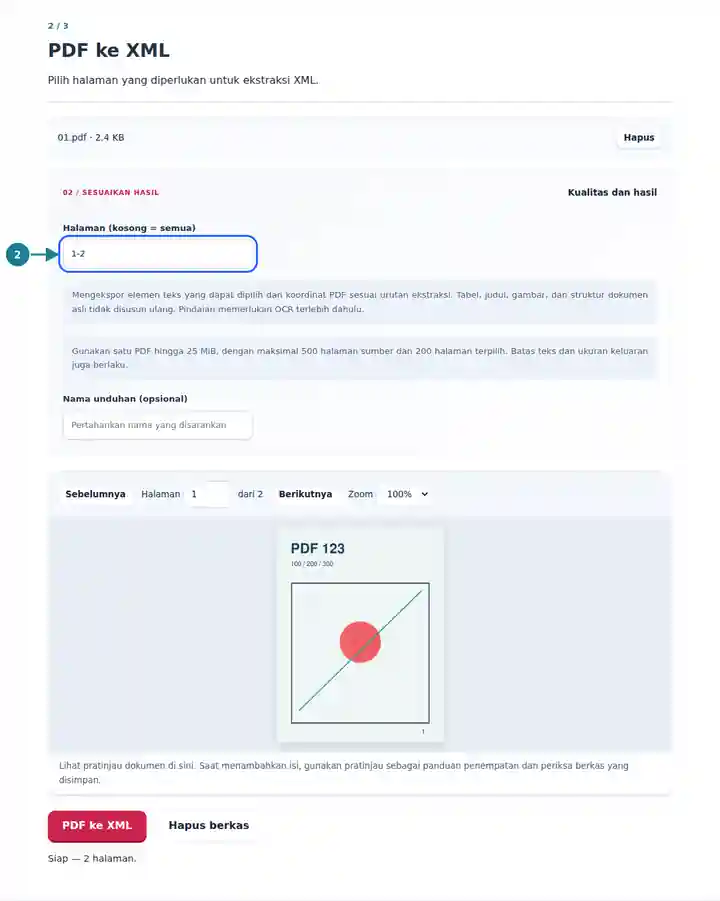
Unduh XML dan periksa elemen halamannya.
Pilih tangkapan layar untuk memperbesarnya.
Tangkapan layar menampilkan alat ini dengan berkas contoh tanpa data sensitif. Nama berkas, jumlah halaman, dan pengaturan Anda mungkin berbeda.
Alur berbasis XML mungkin membutuhkan elemen halaman dan teks yang jelas sebelum menerapkan aturan transformasinya sendiri. Tim dapat memeriksa elemen tersebut, mempertahankan rujukan halaman sumber, dan membuat pemetaan terpisah untuk jenis dokumen yang dikenal. Pisahkan pemetaan dari ekstraksi: kedekatan satu elemen teks dengan elemen lain tidak dengan sendirinya menetapkan hubungan bisnis.
Gunakan elemen halaman dan teks sebagai masukan untuk alur pemrosesan dokumen yang terkendali.
Periksa apakah teks tetap tersedia bersama PDF asli yang disimpan.
Bandingkan nilai sampel hasil dengan halaman sumber sebelum menerima aturan transformasi.
| Pengaturan | Hasil yang diharapkan |
|---|---|
| Sumber | Satu PDF hingga 25 MiB, dengan maksimal 500 halaman sumber. |
| Rentang halaman | Maksimal 200 halaman terpilih. Rentang kosong hanya menyertakan semua halaman jika masih dalam batas tersebut. |
| Batas teks | Hingga 20.000 elemen per halaman, 100.000 per proses, dan dua juta karakter teks. |
| Unduhan | Dokumen XML hingga 64 MiB. Tidak ada DTD atau skema eksternal yang diambil. |
Untuk dokumen pengiriman, ekspor satu halaman dan temukan nomor rujukan yang dikenal. Periksa transformasi teksnya dan elemen di sekitarnya dengan halaman asli. Aplikasi Anda kemudian dapat menerapkan aturan untuk jenis dokumen tersebut. Hindari menganggap setiap angka yang berdekatan sebagai bidang yang sama pada tata letak yang tidak berkaitan.
| Situasi | Yang perlu diperiksa |
|---|---|
| XML tidak cocok dengan skema pemasok | Ekspor menggunakan struktur ekstraksinya sendiri. Buat pemetaan terpisah ke skema yang diharapkan sistem penerima. |
| Suatu elemen memiliki atribut encoding | Jika nilai encoding adalah json, uraikan teksnya sebagai untai JSON untuk memulihkan karakter yang tidak dapat ditulis langsung dalam XML. |
| Kata hilang atau urutannya tidak diharapkan | Periksa halaman pindaian atau penempatan teks yang tidak biasa. Terapkan OCR bila perlu dan tinjau koordinatnya. |
Tidak. PDF umumnya tidak menyimpan model data sumber. Ekspor ini mencatat lapisan teks dan geometri yang dapat diekstrak pembaca.
Tidak. Alat tidak menyusun ulang semantik PDF bertag, judul, atau struktur tabel. Elemen halaman dan teksnya menjelaskan hasil ekstraksi.
Alat XML ke PDF dapat mencetak sumber XML, tetapi tidak dapat membangun ulang desain halaman asli dari berkas ekstraksi ini. Simpan PDF asli.