PDF avec recherche ou TXT
Téléchargez le texte reconnu en texte brut ou ajoutez une couche de texte dans un PDF qui conserve l’apparence de la numérisation.

Rendez les numérisations recherchables en conservant l’apparence des pages.
Déposez les fichiers ici ou utilisez le bouton ci-dessous.
Jusqu’à 100 Mo au total · Les fichiers restent sur votre appareil
Visualisez le document ici. Pour le contenu ajouté, cet aperçu sert de guide de placement ; vérifiez le fichier enregistré.
Ajoutez une couche de texte recherchable à un PDF numérisé avec Tesseract exécuté dans votre navigateur. Choisissez la langue du document source ; le français est sélectionné par défaut. Les lecteurs compatibles pourront rechercher et sélectionner les mots reconnus, tandis que la page numérisée conservera son apparence d’origine.
Par défaut, l’opération conserve les pages qui contiennent déjà du texte. Vous pouvez aussi reconnaître chaque page sélectionnée ; cela ajoute une nouvelle couche et peut dupliquer le texte existant. La précision de l’OCR dépend de la netteté, du contraste, de la langue et de l’alignement de la page. Les petits caractères, l’écriture manuscrite, les polices inhabituelles et les numérisations bruitées nécessitent une vérification attentive plutôt qu’une confiance automatique.
Téléchargez le texte reconnu en texte brut ou ajoutez une couche de texte dans un PDF qui conserve l’apparence de la numérisation.
Le téléchargement contient uniquement les pages sélectionnées. Choisissez jusqu’à 20 pages ; laissez « Pages » vide pour inclure le document entier uniquement s’il compte 20 pages ou moins.
Choisissez la langue source, 200 ou 300 DPI, une rotation pour la reconnaissance et une disposition automatique, en bloc unique ou en texte épars. Les langues prises en charge figurent dans la FAQ ci-dessous.
Les pages qui contiennent déjà du texte peuvent être conservées. Forcez la reconnaissance uniquement après avoir pris en compte le risque de couches de texte dupliquées.
Une numérisation stocke la page sous forme d’image ; une recherche textuelle ordinaire ne peut donc pas retrouver les mots qui y sont imprimés. L’OCR dans la langue sélectionnée peut rendre une numérisation de texte dactylographié interrogeable et fournir du texte pour le copier-coller ou une extraction ultérieure. Il est particulièrement utile pour les archives dans lesquelles retrouver un nom ou une expression connue compte davantage que refaire la mise en page. La couche reconnue peut contenir des erreurs même lorsque la numérisation semble nette. Testez la recherche et la sélection, puis comparez les noms, les références et les nombres avec l’image de page avant d’utiliser le texte extrait.
Rendez un court document dactylographié recherchable par titre, nom ou numéro de référence. Conservez la numérisation d’origine et testez ces termes dans la copie téléchargée, y compris les caractères faciles à confondre.
Rendez les notes de cours dactylographiées interrogeables avant de constituer des notes d’étude. Les annotations manuscrites peuvent rester peu fiables ; vérifiez donc les passages cités par rapport à la numérisation.
Extrayez le texte d’une note numérisée approuvée pour un index interne. Comparez attentivement les dates, les noms du personnel et les numéros de référence, car un seul caractère reconnu peut modifier un identifiant.
Choisissez une numérisation dans une langue prise en charge et sélectionnez jusqu’à 20 pages.
Sélectionnez la capture d’écran pour l’agrandir.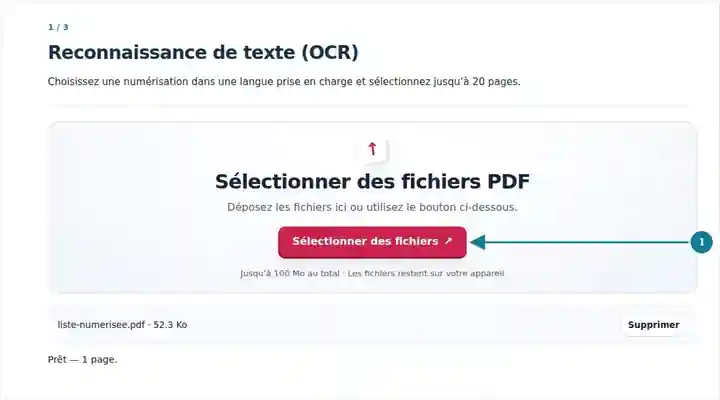
Choisissez la langue source, le résultat OCR, la résolution, la disposition et l’orientation de reconnaissance.
Sélectionnez la capture d’écran pour l’agrandir.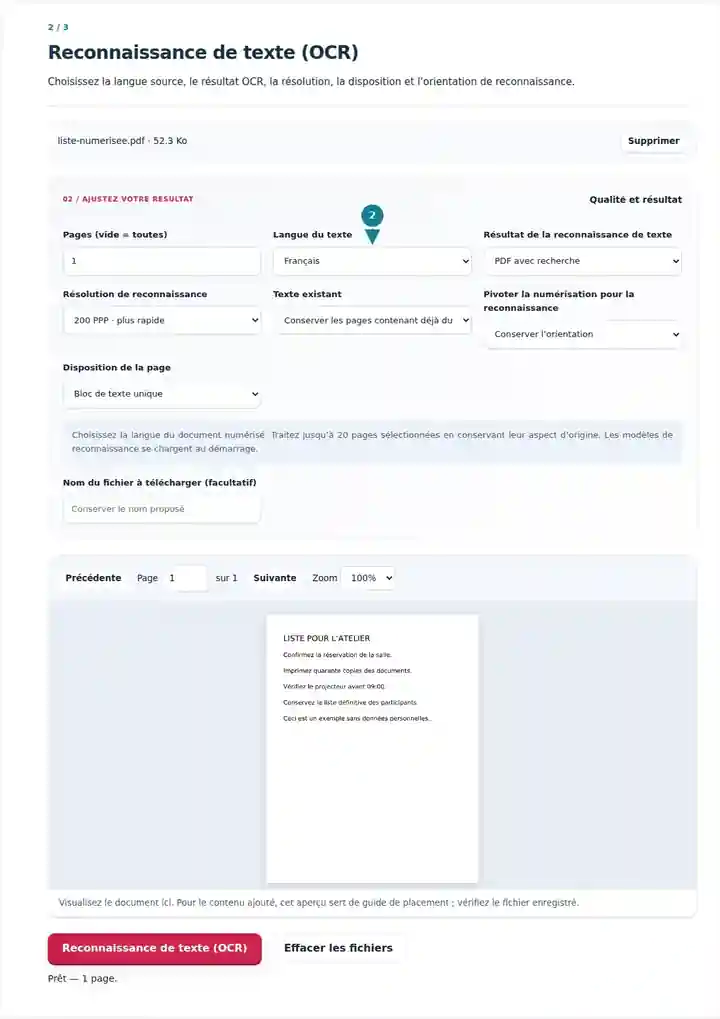
Téléchargez le résultat et comparez le texte reconnu à la numérisation d’origine.
Sélectionnez la capture d’écran pour l’agrandir.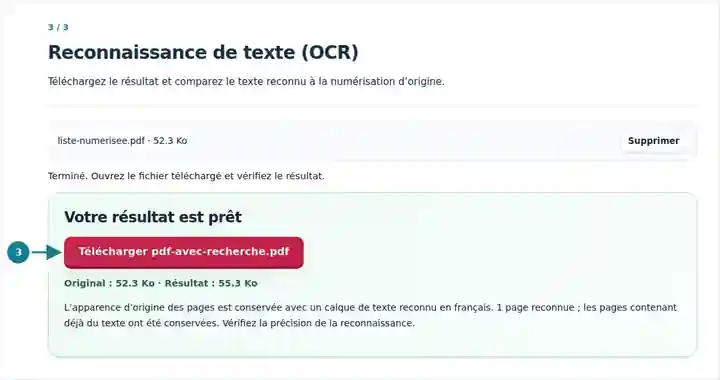
Les captures d’écran présentent cette boîte à outils avec des fichiers d’exemple sans données sensibles. Le nom de votre fichier, le nombre de pages et les réglages peuvent différer.
La page source est une image sans texte extractible. L’OCR ajoute une couche de texte tout en conservant l’apparence visible de la page. Les deux images ont donc le même aspect ; le résultat téléchargeable contient également les mots reconnus.
L’extraction de texte de la source a renvoyé zéro caractère.
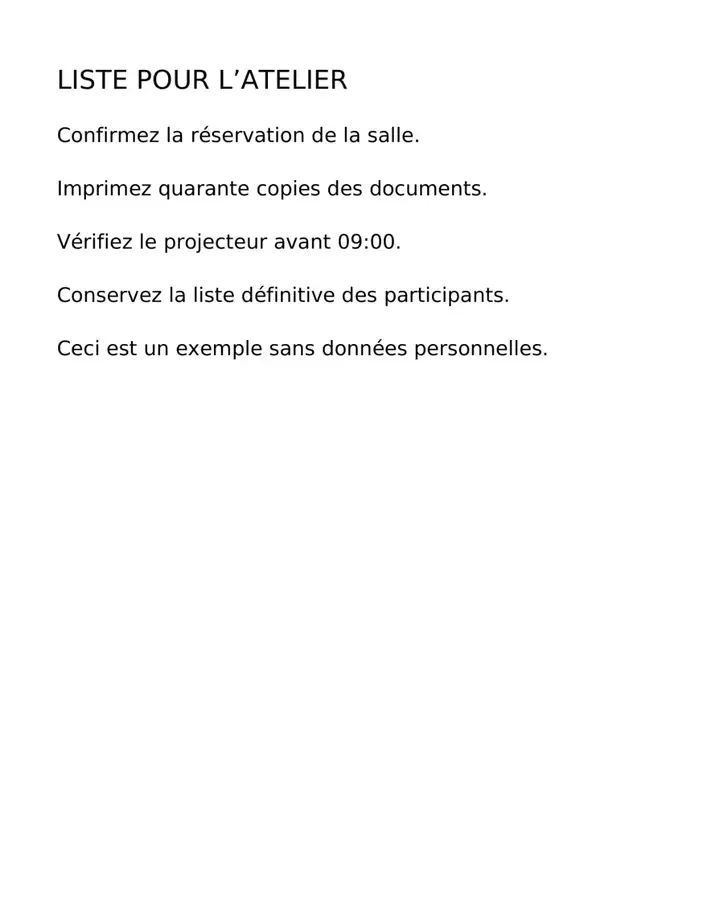
Le résultat contient les six lignes de l’exemple. Ses pixels rendus correspondent à la source à la taille d’image testée de 1 300 pixels.
LISTE POUR L'ATELIER
Confirmez la réservation de la salle.
Imprimez quarante copies des documents.
Vérifiez le projecteur avant 09:00.
Conservez la liste définitive des participants.
Ceci est un exemple sans données personnelles.
Réglages utilisés : Page 1 ; PDF avec recherche ; français ; reconnaissance à 200 PPP ; bloc de texte unique ; orientation d’origine.
Cet exemple français net et en gros caractères n’est pas un étalon de précision pour les petits caractères, l’écriture manuscrite, les numérisations inclinées ou les autres langues. Relisez les noms, les montants et les dates dans votre propre résultat.
Vérifié le . Exemples sans données sensibles traités dans l’édition française du thème 3.10.0 avec un navigateur Chromium local. Ces exemples ne constituent pas un test de performance d’un hébergement en production.
| Réglage | À quoi s’attendre |
|---|---|
| Formats acceptés | |
| Lieu du traitement | Votre navigateur, sur votre appareil |
| Sélection des fichiers | Un fichier source |
| Taille des fichiers sources | Jusqu’à 100 Mo, sous réserve de la mémoire de l’appareil et des limites des pages décodées |
| Lot de reconnaissance | Jusqu’à 20 pages sélectionnées ; seules ces pages figurent dans le PDF avec recherche téléchargé. |
L’outil ajoute une couche de texte ; il ne reconstitue pas les tableaux dans un classeur modifiable et ne corrige pas les faits contenus dans le document. L’OCR ne remplace pas la vérification des noms, des numéros de compte et des autres textes exigeant une grande précision.
Le réglage de rotation fait pivoter la numérisation rendue fournie à la reconnaissance ; le PDF avec recherche conserve l’apparence visible de la page source. Il ne remplace pas Faire pivoter un PDF lorsque vous souhaitez que les lecteurs voient la page à l’endroit. Si une couche de texte existante contient des erreurs, forcer la reconnaissance peut ajouter une autre couche et produire des résultats de recherche en double. Un OCR en texte brut peut constituer une extraction vérifiée utile dans cette situation. Comparez à l’image les caractères faciles à confondre, comme 0/O, 1/l et les points décimaux.
| Situation | Que faire |
|---|---|
| Un nom ou un nombre est incorrect | Comparez le texte reconnu avec l’image. Corrigez-le dans un éditeur adapté utilisé ensuite avant de le réemployer. |
| Une mauvaise couche OCR existante ne s’est pas améliorée | Choisissez « Reconnaître chaque page sélectionnée » pour ajouter une nouvelle couche. Le texte existant est conservé ; une couche déjà présente peut donc produire des résultats de recherche en double. Exportez du texte brut si vous avez besoin d’une extraction propre. |
| Un long dossier est refusé | Divisez-le en groupes de 20 pages ou moins, appliquez l’OCR à chaque groupe et vérifiez-les avant de les fusionner. |
Pour une fiche d’inspection dactylographiée, recherchez un identifiant d’équipement connu dans le PDF avec recherche, puis copiez cet identifiant et une mesure dans un éditeur de texte. Comparez-les tous deux avec la numérisation et confirmez que la sélection met en évidence la ligne voulue. Une recherche de mot réussie ne suffit pas à établir un ordre de lecture correct ou une extraction numérique fiable.
Le résultat reste un PDF avec une couche de texte ajoutée. Utilisez ensuite PDF en Word si vous avez besoin d’un document textuel dont la mise en page peut se réorganiser.
Cette version inclut les modèles de reconnaissance du français, de l’anglais, de l’espagnol, du portugais, de l’allemand, de l’indonésien, du russe, de l’italien, du turc, de l’arabe, du chinois simplifié, du japonais, du coréen, du polonais et de l’hindi. Le français est la langue par défaut ; sélectionnez celle qui correspond à la source. L’OCR reconnaît les caractères, mais ne traduit pas le document. Les autres langues nécessitent une méthode OCR configurée séparément.
Le réglage par défaut conserve les pages disposant déjà d’une couche de texte. Sélectionnez « Reconnaître chaque page sélectionnée » pour lancer également la reconnaissance sur celles-ci.
Non. Le PDF avec recherche contient uniquement les pages sélectionnées. Pour conserver un long document complet, reconnaissez des lots de 20 pages maximum, puis combinez les résultats vérifiés dans leur ordre d’origine.
Non. Elle fait pivoter l’image fournie à la reconnaissance tout en conservant l’apparence visible de la page source dans le PDF. Utilisez d’abord Faire pivoter un PDF lorsque la page enregistrée elle-même doit apparaître à l’endroit.
L’outil reconnaît du texte dans la langue choisie ; il ne promet pas une reconnaissance fiable de l’écriture manuscrite et ne reconstruit pas les cellules d’un tableau. Utilisez une numérisation nette et droite de texte dactylographié, puis vérifiez les mots avant de les reprendre dans Word ou un tableur.
Poursuivez avec PDF en Word, PDF en texte, Numérisation en PDF. Pour les exigences de stockage à long terme, consultez la PDF en PDF/A; un PDF avec recherche n’est pas automatiquement un PDF/A.