PDF pesquisável ou TXT
Baixe a redação reconhecida como texto simples ou adicione uma camada de texto sobre a aparência preservada da digitalização em um PDF.

Torne digitalizações pesquisáveis, mantendo a aparência original das páginas.
Arraste seus arquivos para cá ou use o botão abaixo.
Até 100 MB no total · Os arquivos permanecem no seu dispositivo
Confira a prévia do documento aqui. Ao adicionar conteúdo, use-a como referência para posicioná-lo e confira o arquivo salvo.
Adicione uma camada de texto pesquisável a um PDF digitalizado com o Tesseract executado no navegador. Escolha o idioma do original; português do Brasil é o padrão. Leitores compatíveis poderão pesquisar e selecionar palavras reconhecidas enquanto a página digitalizada mantém sua aparência original.
Por padrão, a operação mantém as páginas que já contêm texto. Você também pode reconhecer todas as páginas selecionadas; isso adiciona uma nova camada e pode duplicar qualquer texto existente. A precisão do OCR depende de foco, contraste, idioma e alinhamento das páginas. Letras pequenas, escrita à mão, fontes incomuns e digitalizações com ruído precisam de revisão cuidadosa, não de confiança automática.
Baixe a redação reconhecida como texto simples ou adicione uma camada de texto sobre a aparência preservada da digitalização em um PDF.
O download contém apenas as páginas selecionadas. Escolha até 20 páginas; deixe Páginas em branco para incluir o documento inteiro apenas quando ele tiver 20 páginas ou menos.
Escolha o idioma do original, 200 ou 300 DPI, uma rotação para reconhecimento e um layout automático, de bloco único ou de texto esparso. Os idiomas compatíveis estão listados nas perguntas frequentes abaixo.
Páginas que já contêm texto podem ser mantidas. Force o reconhecimento apenas depois de considerar a possibilidade de camadas de texto duplicadas.
Uma digitalização armazena a página como uma imagem; por isso, a pesquisa de texto comum não consegue encontrar as palavras impressas nela. O OCR no idioma selecionado pode tornar pesquisável uma digitalização de texto digitado e fornecer a redação para copiar e colar ou para extração posterior de texto. Ele é especialmente útil para arquivos em que encontrar um nome ou uma frase conhecida é mais importante que redesenhar a página. A camada reconhecida pode conter erros mesmo quando a digitalização parece clara. Teste a pesquisa e a seleção e depois compare nomes, referências e números com a imagem da página antes de usar a redação extraída.
Torne um documento curto digitado pesquisável por título, nome ou número de referência. Guarde a digitalização original e teste esses termos na cópia baixada, incluindo caracteres que possam ser confundidos.
Torne pesquisáveis as notas de curso digitadas antes de criar anotações de estudo. Anotações manuscritas podem continuar pouco confiáveis; por isso, confira trechos citados com a digitalização.
Extraia a redação de um memorando digitalizado aprovado para um índice interno. Compare datas, nomes de funcionários e números de referência com cuidado, pois um único caractere reconhecido pode mudar um identificador.
Escolha uma digitalização em um idioma compatível e selecione até 20 páginas.
Selecione a captura de tela para ampliá-la.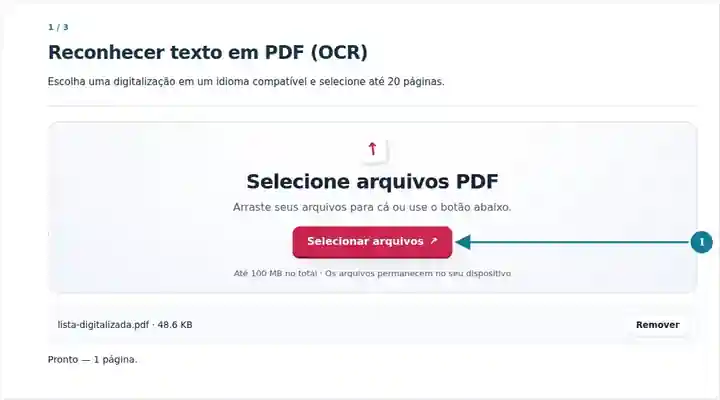
Escolha o idioma de origem, a saída de OCR, a resolução, o layout e a orientação de reconhecimento.
Selecione a captura de tela para ampliá-la.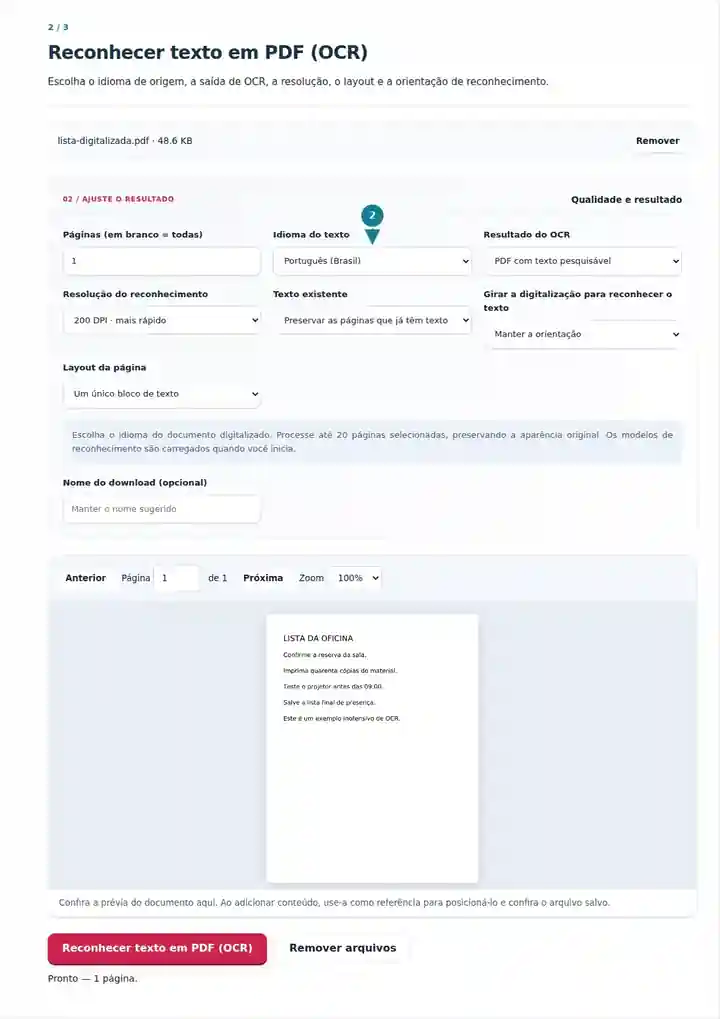
Baixe e teste o texto reconhecido comparando-o com a digitalização original.
Selecione a captura de tela para ampliá-la.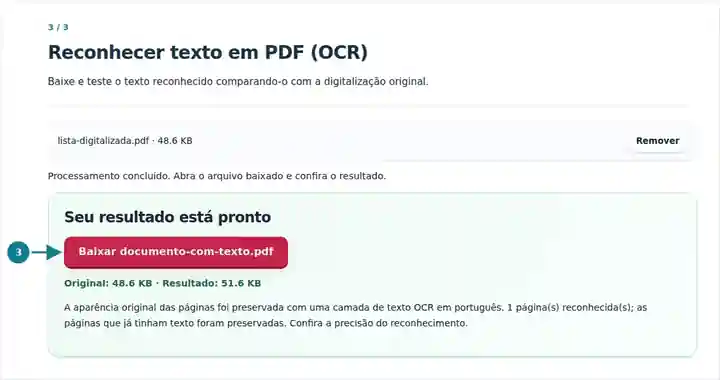
As capturas de tela mostram estas ferramentas com arquivos de exemplo sem dados sensíveis. O nome do seu arquivo, o número de páginas e as configurações podem ser diferentes.
A página de origem é uma imagem sem texto extraível. O OCR adiciona uma camada de texto mantendo a aparência visível da página. Por isso, as duas imagens parecem iguais; o resultado disponível para baixar também contém as palavras reconhecidas.
A extração de texto da origem retornou zero caracteres.
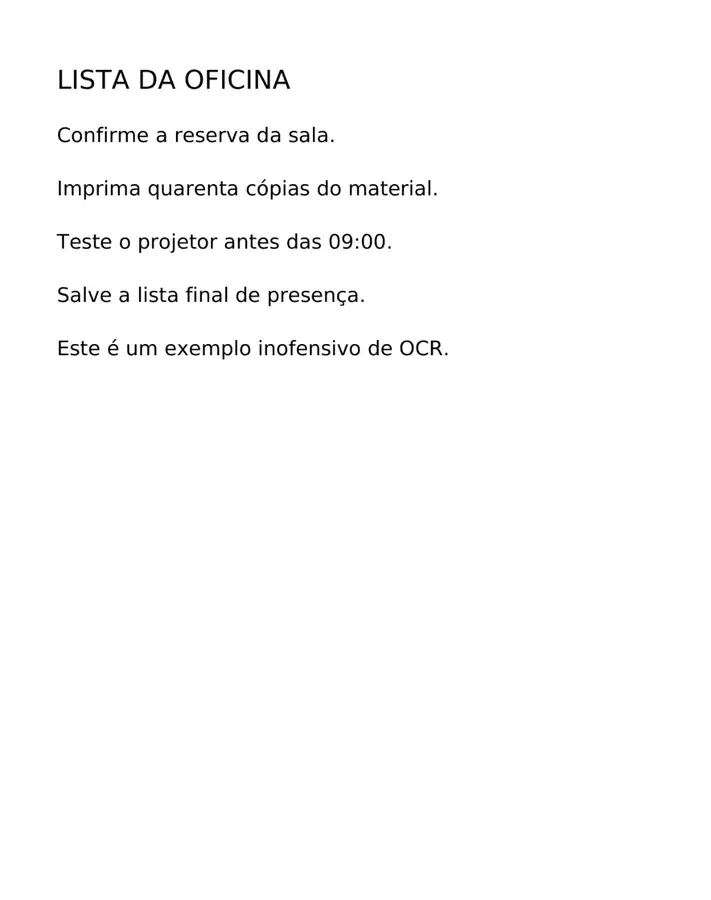
O resultado contém todas as seis linhas do exemplo. Seus pixels renderizados correspondem à origem no tamanho de imagem testado de 1.300 pixels.
LISTA DA OFICINA
Confirme a reserva da sala.
Imprima quarenta cópias do material.
Teste o projetor antes das 09:00.
Salve a
lista final de presença.
Este é um exemplo inofensivo de OCR.
Configurações utilizadas: Página 1; PDF com texto pesquisável; idioma Português (Brasil); reconhecimento a 200 DPI; um único bloco de texto; orientação original.
Este exemplo nítido em português e com letras grandes não é uma avaliação de precisão para letras pequenas, escrita à mão, digitalizações inclinadas ou outros idiomas. Revise nomes, valores e datas no seu próprio resultado.
Verificado em . Arquivos de exemplo sem dados sensíveis processados na interface em português brasileiro do tema 3.7.0, em um navegador Chromium local. Estes exemplos não são uma avaliação da hospedagem em produção.
| Configuração | O que esperar |
|---|---|
| Formato de entrada aceito | |
| Local de processamento | Seu navegador, no seu dispositivo |
| Seleção de arquivos | Um arquivo de entrada |
| Tamanho de entrada | Até 100 MB, sujeito à memória do dispositivo e aos limites de páginas decodificadas |
| Lote de reconhecimento | Até 20 páginas selecionadas; apenas essas páginas aparecem no download do PDF pesquisável. |
A ferramenta adiciona uma camada de texto; ela não reconstrói tabelas como uma planilha editável nem corrige o conteúdo factual. O OCR não substitui a revisão de nomes, números de conta e outros textos que exigem precisão.
A configuração de rotação gira a digitalização renderizada fornecida ao reconhecimento; o PDF pesquisável mantém a aparência visível da página de origem. Ela não substitui Girar PDF quando você deseja que os leitores vejam a página na orientação correta. Se uma camada de texto existente contiver erros, forçar o reconhecimento pode adicionar outra camada e produzir resultados de pesquisa duplicados. O OCR de texto simples pode ser uma extração útil e verificada nessa situação. Compare caracteres facilmente confundidos, como 0/O, 1/l e separadores decimais, com a imagem.
| Situação | O que fazer |
|---|---|
| Um nome ou número está errado | Compare o texto reconhecido com a imagem. Corrija-o em um editor adequado na etapa seguinte antes de reutilizá-lo. |
| Uma camada de OCR ruim existente não melhorou | Escolha Reconhecer todas as páginas selecionadas para adicionar uma nova camada. O texto existente é mantido, então uma camada existente pode produzir resultados de pesquisa duplicados; exporte texto simples se precisar de uma extração limpa. |
| Um conjunto longo é rejeitado | Divida-o em grupos de 20 páginas ou menos, aplique OCR a cada grupo e verifique os resultados antes de juntar. |
Para uma ficha de inspeção digitada, pesquise um identificador conhecido de equipamento no PDF pesquisável e depois copie esse identificador e uma medição para um editor de texto. Compare ambos com a digitalização e confirme que a seleção destaca a linha pretendida. Uma pesquisa de palavra bem-sucedida, por si só, não estabelece uma ordem de leitura correta nem uma extração numérica confiável.
A saída continua sendo um PDF com uma camada de texto adicionada. Use PDF para Word depois se precisar de um documento de texto com fluxo reorganizado.
Esta versão inclui modelos locais de português, espanhol, inglês, alemão, indonésio, russo, francês, italiano, turco, árabe, chinês simplificado, japonês, coreano, polonês e hindi. Português do Brasil é a opção padrão; selecione o idioma correspondente ao documento antes de reconhecer. Documentos em outros idiomas precisam de um fluxo de OCR configurado separadamente.
A configuração padrão mantém páginas com uma camada de texto existente. Selecione Reconhecer todas as páginas selecionadas para executar o reconhecimento nelas também.
Não. O PDF pesquisável contém apenas as páginas selecionadas. Para manter um documento longo junto, reconheça lotes de até 20 páginas e combine as saídas conferidas na ordem original.
Não. Ela gira a imagem fornecida ao reconhecimento enquanto mantém a aparência visível da página de origem no PDF. Use Girar PDF primeiro quando a própria página salva precisar aparecer na orientação correta.
A ferramenta reconhece texto no idioma selecionado; não promete reconhecer manuscritos de forma confiável nem reconstruir células de tabelas. Use uma digitalização nítida de texto digitado, na posição correta, e confira as palavras antes de levá-las para o Word ou uma planilha.
Continue com PDF para Word, PDF para texto, Digitalizar para PDF. Para requisitos de armazenamento de longo prazo, consulte PDF para PDF/A; um PDF pesquisável não é automaticamente PDF/A.