Selezione delle pagine
Esporta un intervallo specifico mantenendo i numeri di pagina originali. In questo modo è più semplice esaminare un piccolo campione prima di elaborare un documento lungo.

Esporta testo selezionabile, geometria delle pagine e posizioni del testo in JSON.
Trascina i file qui oppure usa il pulsante qui sotto.
Fino a 25 MB totali · I file restano sul tuo dispositivo
Visualizza il documento qui. Per il contenuto aggiunto, questa anteprima serve da guida al posizionamento; controlla il file salvato.
Trasforma il livello di testo di un PDF in un file JSON da esaminare o elaborare successivamente. L’esportazione registra le pagine selezionate, le loro dimensioni e gli elementi di testo restituiti dal lettore PDF, comprese posizioni e trasformazioni.
Un PDF memorizza istruzioni per visualizzare una pagina. Questo strumento non deduce i campi delle fatture, non ricostruisce tabelle e non identifica i livelli dei titoli originali. Le pagine scansionate richiedono OCR prima che le loro parole possano comparire nell’esportazione.
Esporta un intervallo specifico mantenendo i numeri di pagina originali. In questo modo è più semplice esaminare un piccolo campione prima di elaborare un documento lungo.
Conserva gli elementi di testo insieme alla geometria delle pagine e alle informazioni di posizione. Usa il PDF originale per interpretare le coordinate e verificare le relazioni visive tra gli elementi.
Scarica JSON valido per il tuo analizzatore o processo di revisione. Il testo esportato viene sottoposto a escape come dato; lo strumento non esegue il contenuto del documento.
Leggi il PDF selezionato nel browser. Il documento non viene inviato a un server di conversione e il file originale non viene modificato.
Scegli un PDF contenente testo selezionabile.
Seleziona la schermata per ingrandirla.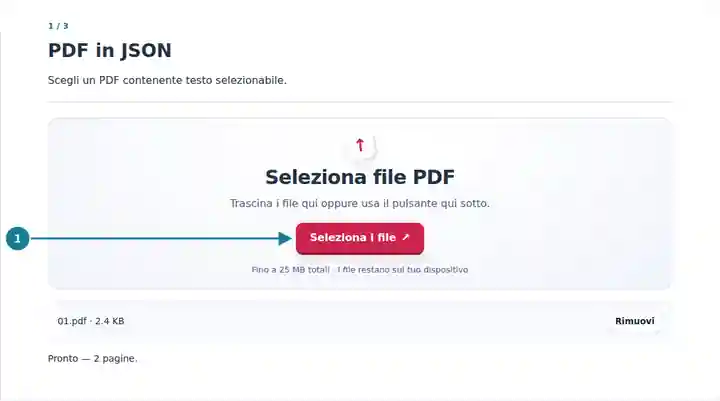
Imposta l’intervallo di pagine e controlla i limiti di estrazione.
Seleziona la schermata per ingrandirla.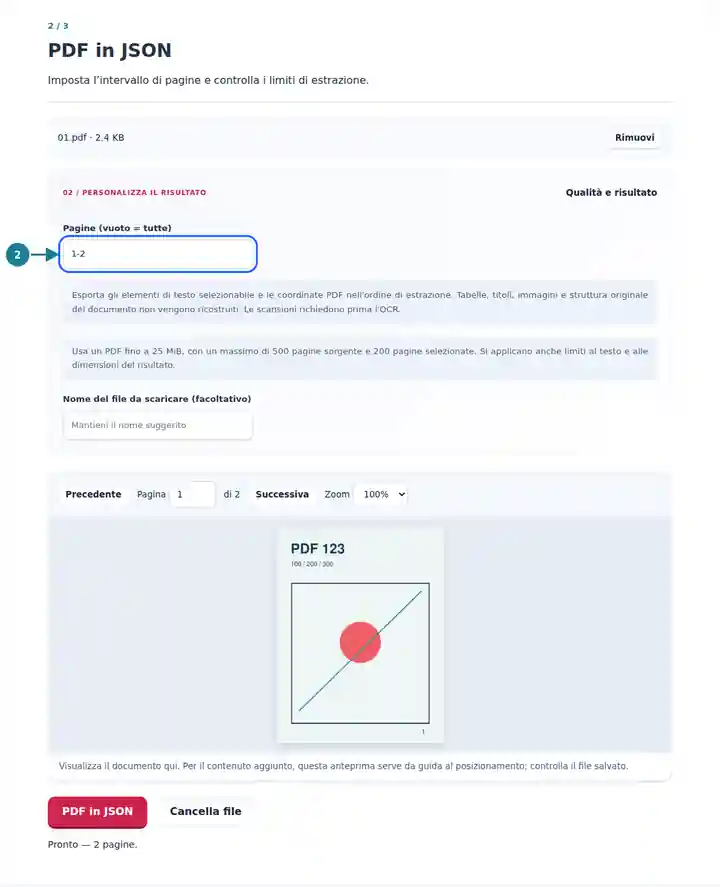
Salva il JSON e confrontalo con la pagina di origine.
Seleziona la schermata per ingrandirla.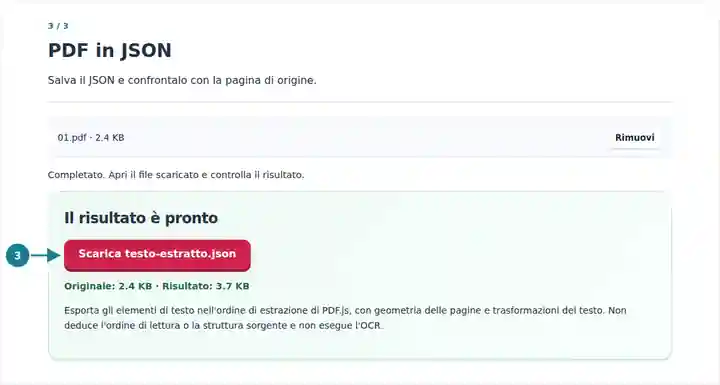
Le schermate mostrano questo toolkit con file di esempio privi di dati sensibili. Il nome del file, il numero di pagine e le impostazioni possono differire.
JSON è utile quando un flusso documentale richiede sia il testo sia la sua posizione. Uno sviluppatore può esaminare la qualità dell’estrazione, individuare etichette ripetute o preparare una mappatura separata. Definisci questa mappatura esplicitamente: un importo vicino non è automaticamente il totale di una fattura e l’ordine di estrazione non coincide necessariamente con quello di lettura umano.
Esamina il livello di testo prima di creare un analizzatore e conserva i riferimenti di pagina per il debug.
Confronta i valori campione con la pagina di origine prima di accettare una regola di estrazione.
Esplora come viene rappresentato il testo visibile in un documento a impaginazione fissa.
| Impostazione | Cosa aspettarsi |
|---|---|
| Ingresso | Un PDF fino a 25 MiB, con un massimo di 500 pagine di origine. |
| Selezione | Fino a 200 pagine selezionate; al massimo 20.000 elementi di testo per pagina, 100.000 per elaborazione e due milioni di caratteri di testo. |
| Uscita | JSON contenente testo estratto e geometria; massimo 64 MiB. |
| Pagine scansionate | Nessun OCR automatico, esportazione di immagini o riconoscimento dei campi del documento. |
Per un prospetto a due colonne, esporta prima una pagina. Individua un’etichetta conosciuta e confrontane la posizione con il valore stampato. Se gli elementi delle due colonne sono mescolati, raggruppali mediante le coordinate nel tuo codice anziché considerare l’array come una tabella già pronta.
| Situazione | Cosa controllare |
|---|---|
| Non viene trovato testo selezionabile | Esegui OCR sulle pagine scansionate, quindi esporta il livello di testo del PDF ottenuto. |
| Il testo compare in un ordine inatteso | Confronta la pagina e le posizioni del testo: l’ordine di estrazione non definisce quello di lettura. |
| Una selezione grande viene rifiutata | Scegli meno pagine. Le pagine dense possono raggiungere il limite degli elementi di testo prima di quello delle pagine. |
No. Il risultato contiene elementi di testo e geometria. Nomi dei campi, relazioni e validazione delle regole aziendali richiedono una mappatura separata.
Le immagini non vengono esportate. Il testo di una tabella può essere estratto, ma le relazioni tra righe e colonne non vengono ricostruite.
L’esportazione è un formato di analisi, non una rappresentazione completa del PDF. Conserva il PDF originale per aspetto, grafica, caratteri e funzioni interattive.