Selección de páginas
Exporta un intervalo concreto conservando los números de página originales. Así resulta más fácil revisar una muestra pequeña antes de procesar un documento largo.

Exporta texto seleccionable, geometría de página y posiciones de texto a JSON.
Arrastra aquí tus archivos o usa el botón de abajo.
Hasta 25 MB en total · Los archivos permanecen en tu dispositivo
Revisa aquí la vista previa del documento. Si añades contenido, úsala como guía para colocarlo y comprueba el archivo guardado.
Convierte la capa de texto de un PDF en un archivo JSON para revisarlo o procesarlo después. La exportación registra las páginas seleccionadas, sus dimensiones y los elementos de texto que devuelve el lector de PDF, incluidas sus posiciones y transformaciones.
Un PDF almacena instrucciones para mostrar una página. Esta herramienta no deduce campos de facturas, reconstruye tablas ni identifica los niveles de los encabezados originales. Las páginas escaneadas necesitan OCR para que sus palabras puedan aparecer en la exportación.
Exporta un intervalo concreto conservando los números de página originales. Así resulta más fácil revisar una muestra pequeña antes de procesar un documento largo.
Conserva los elementos de texto junto con la geometría de página y la información de posición. Usa el PDF original para interpretar las coordenadas y comprobar la relación visual entre los elementos.
Descarga JSON válido para tu propio analizador o proceso de revisión. El texto exportado se escapa como datos; la herramienta no ejecuta el contenido del documento.
Lee el PDF seleccionado en tu navegador. El documento no se envía a un servidor de conversión y el archivo original no se modifica.
Elige un PDF que contenga texto seleccionable.
Selecciona la captura para ampliarla.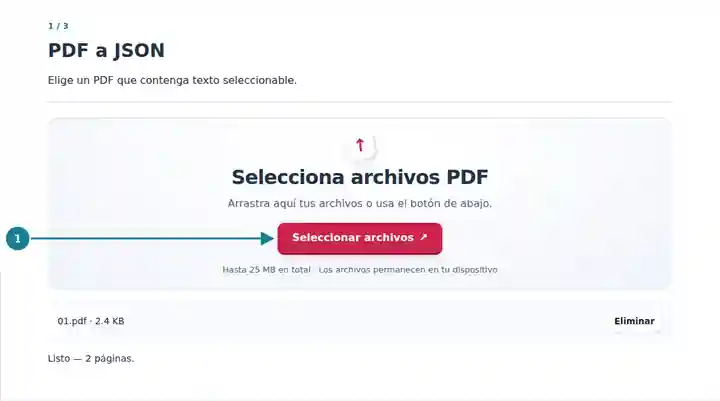
Configura el intervalo de páginas y revisa los límites de extracción.
Selecciona la captura para ampliarla.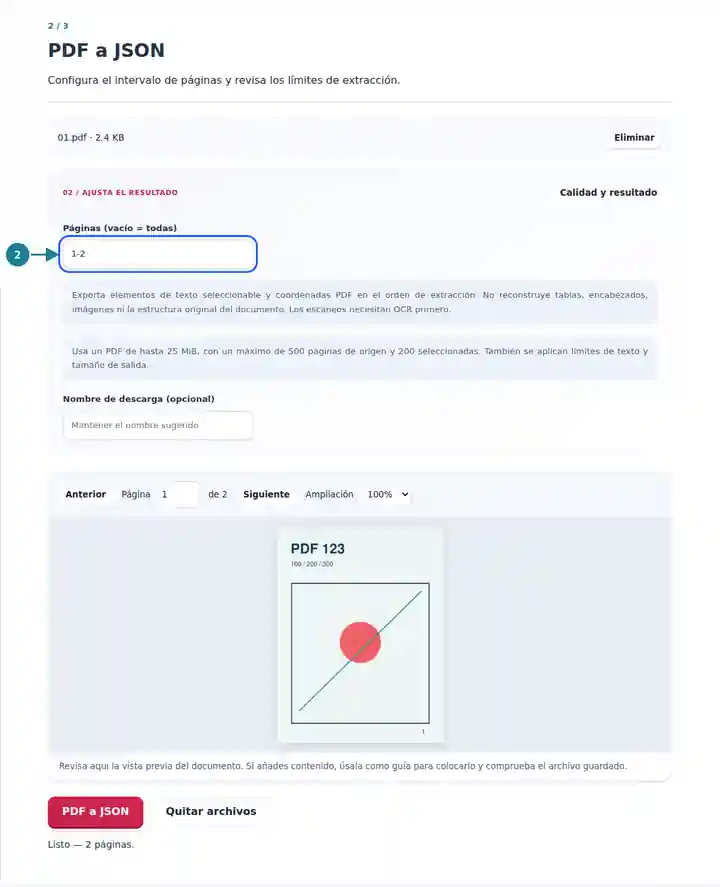
Guarda el JSON y compáralo con la página de origen.
Selecciona la captura para ampliarla.
Las capturas muestran estas herramientas con archivos de ejemplo sin datos sensibles. El nombre de tu archivo, el número de páginas y los ajustes pueden ser diferentes.
JSON resulta útil cuando un proceso documental necesita tanto el texto como su posición. Un desarrollador puede revisar la calidad de la extracción, localizar etiquetas repetidas o preparar una asignación de campos independiente. Esa asignación debe ser explícita: un importe cercano no es automáticamente el total de una factura, y el orden de extracción no tiene por qué coincidir con el orden de lectura de una persona.
Revisa la capa de texto antes de crear un analizador y conserva las referencias de página para depurar errores.
Compara valores de muestra con la página de origen antes de aceptar una regla de extracción.
Explora cómo se representa el texto visible en un documento de diseño fijo.
| Ajuste | Qué esperar |
|---|---|
| Entrada | Un PDF de hasta 25 MiB y hasta 500 páginas de origen. |
| Selección | Hasta 200 páginas seleccionadas; hasta 20.000 elementos de texto por página, 100.000 por tarea y dos millones de caracteres de texto. |
| Resultado | JSON con texto extraído y geometría; máximo de 64 MiB. |
| Páginas escaneadas | Sin OCR automático, exportación de imágenes ni reconocimiento de campos del documento. |
Para un extracto con dos columnas, exporta primero una página. Localiza una etiqueta conocida y compara su posición con el valor impreso. Si los elementos de ambas columnas aparecen intercalados, agrúpalos mediante las coordenadas en tu propio código, en lugar de dar por hecho que la matriz ya es una tabla terminada.
| Situación | Qué comprobar |
|---|---|
| No se encuentra texto seleccionable | Aplica OCR a las páginas escaneadas y después exporta la capa de texto del PDF resultante. |
| El texto aparece en un orden inesperado | Compara la página y las posiciones del texto; el orden de extracción no establece el orden de lectura. |
| Se rechaza una selección grande | Elige menos páginas. Las páginas densas pueden alcanzar el límite de elementos de texto antes que el límite de páginas. |
No. El resultado contiene elementos de texto y geometría. Los nombres de campo, las relaciones y la validación de negocio requieren un proceso de asignación independiente.
Las imágenes no se exportan. Es posible extraer el texto de una tabla, pero no se reconstruyen las relaciones entre filas y columnas.
La exportación es un formato de inspección, no una representación completa del PDF. Conserva el PDF original para mantener la apariencia, los gráficos, las fuentes y las funciones interactivas.