按页面组织的元素
将源页码、旋转角度和可见页面边界与提取文本一起保留,便于审核所选页面范围时参照。

将 PDF 文本项与页面几何信息提取到有明确说明的 XML 结构中。
将文件拖到此处,或使用下方按钮选择文件。
上限为 25 MB 总计 · 文件保留在您的设备上
在此预览文档。对于新添加的内容,预览仅用于辅助确定位置;请检查保存后的输出结果。
将 PDF 的可选择文本层导出为 XML。文件按照原始页码对文本项分组,并记录页面几何信息、文本方向和定位变换,为检查和后续处理提供结构化依据。
XML 描述的是 PDF 文本阅读器提取到的内容。它不是可能曾用于生成该文档的原始 XML,也不会识别发票字段、重建表格关系或导出图片。纯图片页面需要先进行 OCR。
将源页码、旋转角度和可见页面边界与提取文本一起保留,便于审核所选页面范围时参照。
与号、尖括号等字符仍作为数据保留在 XML 元素内。看起来像标记的文本不会通过此导出变成可执行的页面内容。
XML 无法直接表示的字符会使用明确标注的 JSON 字符串编码。接收程序可以根据该标记准确还原这些值。
在您的设备上创建 XML 文件。源文件既不会上传进行转换,也不会被重写。
选择具有可读文本层的 PDF。
点击截图可放大查看。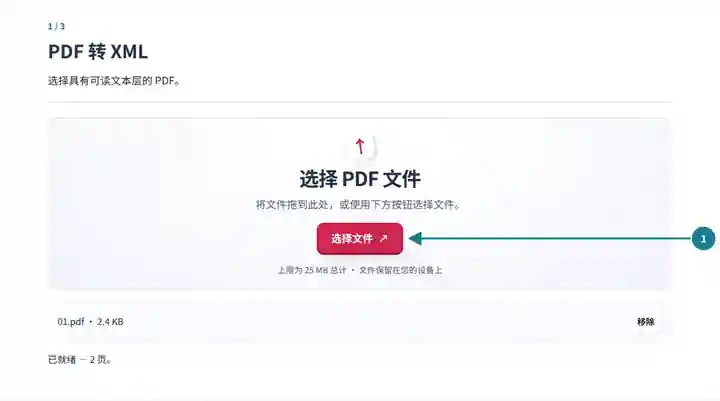
选择 XML 提取所需的页面。
点击截图可放大查看。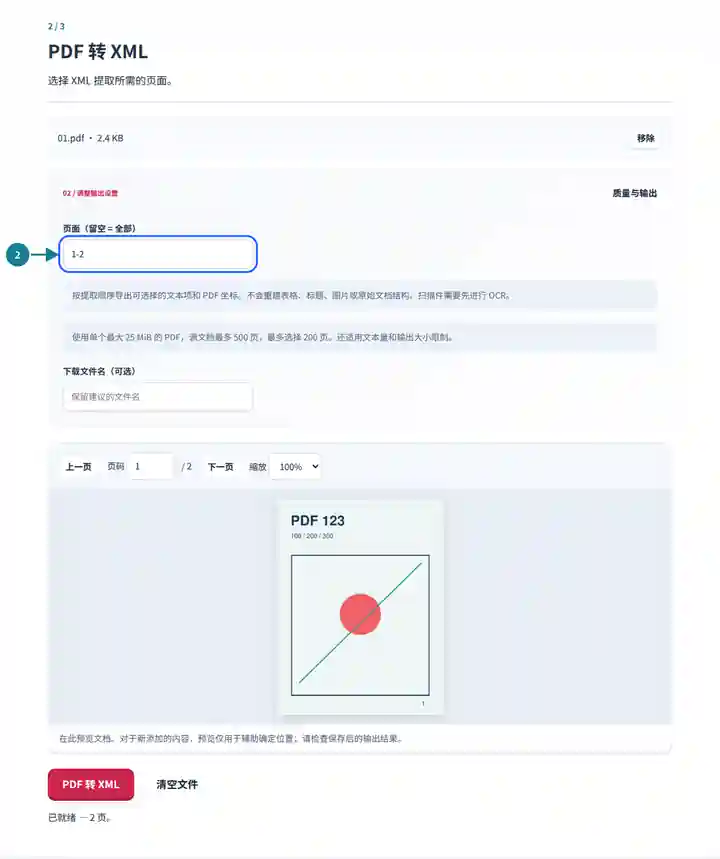
下载 XML 并检查页面元素。
点击截图可放大查看。
截图展示了使用不含敏感信息的示例文件操作本工具箱的过程。您的文件名、页数和设置可能不同。
基于 XML 的工作流程可能需要明确的页面元素和文本项元素,才能应用自身的转换规则。团队可以检查这些元素、保留源页面引用,并针对已知文档类型建立独立映射。请区分映射与提取:文本项彼此靠近,本身并不能确立业务关系。
将页面元素和文本项元素作为受控文档处理流程的输入。
检查在保留原始 PDF 的同时,文本是否仍然可用。
接受转换规则之前,将输出值样本与其源页面进行比较。
| 设置 | 预期结果 |
|---|---|
| 源文件 | 单个 PDF,最大 25 MiB,源文档不超过 500 页。 |
| 页面范围 | 最多选择 200 页。仅当总页数未超出此限制时,空范围才会包含所有页面。 |
| 文本限制 | 每页最多 20,000 项,每次任务最多 100,000 项及 200 万个文本字符。 |
| 下载文件 | 最大 64 MiB 的 XML 文档。不会获取外部 DTD 或模式文件。 |
对于送货单,可先导出一页并找到熟悉的参考编号。对照原始页面,检查其文本变换和附近的文本项。随后,您的应用便可应用该文档类型的专用规则。不要在互不相关的布局中,把附近所有数字都视为同一字段。
| 情况 | 检查事项 |
|---|---|
| XML 不符合供应商的模式 | 导出使用自己的提取结构。请另行建立映射,以满足接收系统预期的模式。 |
| 元素具有 encoding 属性 | 如果 encoding 为 json,请将其文本解析为 JSON 字符串,以还原不能直接出现在 XML 中的字符。 |
| 文字缺失或顺序不符合预期 | 检查是否存在扫描页面或特殊文本位置。根据需要运行 OCR,并检查坐标。 |
不会。PDF 通常不保留源数据模型。此导出记录的是阅读器能够提取的文本层和几何信息。
不会。工具不会重建带标签 PDF 的语义、标题或表格结构。页面元素和文本项元素仅描述提取结果。
XML 转 PDF 工具可以打印 XML 源文本,但不能根据此提取文件重建原始页面设计。请保留原始 PDF。