Настоящее декодирование DjVu
Встроенная библиотека DjVu.js декодирует данные изображений документа. Результат — новое изображение страницы PDF, а не вложенный DjVu или переименованный исходный файл.

Декодируйте автономные документы DjVu в изображения страниц PDF.
Перетащите файлы сюда или используйте кнопку ниже.
До 50 МБ всего · Файлы остаются на вашем устройстве
Просмотрите документ здесь. При добавлении содержимого используйте предварительный просмотр для размещения элементов и проверьте сохранённый результат.
Преобразуйте автономный документ DjVu в PDF с декодированными изображениями страниц. Поддерживаются одностраничные файлы и объединённые документы, содержащие все необходимые данные изображений. Выберите отдельные страницы или преобразуйте весь документ в пределах указанных ограничений.
Косвенный индекс DjVu зависит от отдельных файлов страниц. Такой ввод отклоняется, поскольку инструмент принимает один локальный документ и не получает его зависимости из другого места. Существующие текстовые слои, ссылки и закладки DjVu не переносятся в PDF.
Встроенная библиотека DjVu.js декодирует данные изображений документа. Результат — новое изображение страницы PDF, а не вложенный DjVu или переименованный исходный файл.
Выберите нужные номера страниц из объединённого документа. Небольшие выборки легче проверять; они могут укладываться в ограничения памяти, которые превысила бы целая отсканированная книга.
Декодированные изображения страниц учитывают сохранённый поворот. Каждая страница PDF использует декодированные размеры в пикселях и сведения о разрешении источника для определения физического размера.
Выбранный файл читается локально. Отсутствующие косвенные страницы не запрашиваются, ссылки документа не активируются, а DjVu не загружается на сервер.
Выберите полный документ DjVu, сохранённый в одном файле.
Нажмите на снимок экрана, чтобы увеличить его.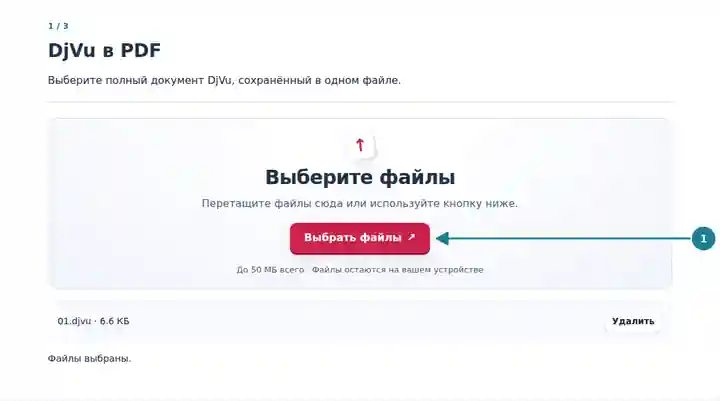
Выберите страницы в пределах ограничений декодирования.
Нажмите на снимок экрана, чтобы увеличить его.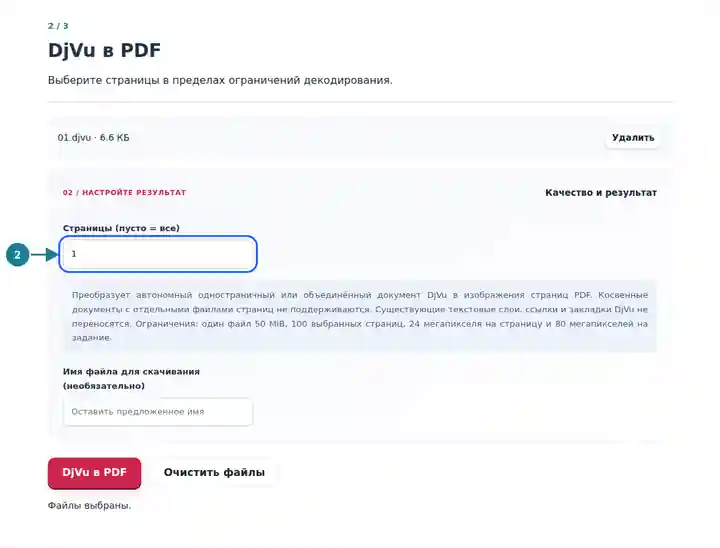
Сохраните PDF и проверьте число страниц, поворот и читаемость.
Нажмите на снимок экрана, чтобы увеличить его.
Снимки экрана показывают этот набор инструментов с безопасными примерными файлами. Имя вашего файла, количество страниц и настройки могут отличаться.
PDF-копия позволяет получателям и документным системам без поддержки DjVu просматривать или печатать выбранные страницы. Она не добавляет отсутствующие детали скана, не исправляет повреждённые страницы и не создаёт поисковый текст автоматически. Сохраните DjVu, если вам по-прежнему нужна его исходная навигация или текстовая информация.
Создайте читаемую PDF-копию выбранных справочных страниц, сохранив исходный документ и сведения для цитирования.
Открывайте учебные материалы в PDF-просмотрщике, если они были предоставлены в виде автономного файла DjVu.
Подготовьте просматриваемую копию для процесса, принимающего изображения страниц PDF, и проверьте наличие всех необходимых страниц.
| Настройка | Что ожидать |
|---|---|
| Входной файл | Один автономный файл .djvu или .djv размером до 50 MiB и не более 500 исходных страниц. |
| Выбор страниц | До 100 выбранных страниц. Пустой диапазон включает все страницы только при соблюдении ограничений. |
| Декодированные изображения | До 24 мегапикселей на страницу и 80 мегапикселей суммарно для выбранных страниц. |
| Результат | Один PDF с изображениями страниц. Исходные текстовые слои, ссылки и закладки DjVu не копируются. |
Если объединённый отчёт содержит большое отсканированное приложение, начните с нескольких страниц, нужных для проверки. Укажите диапазон и убедитесь, что число страниц PDF соответствует ожиданиям. Сравните мелкую подпись и повёрнутую схему с оригиналом. Если затем выполняете OCR, отдельно проверяйте имена, числа и необычные символы.
| Ситуация | Что проверить |
|---|---|
| Документу нужны отдельные файлы страниц | Выберите объединённую копию, содержащую данные страниц. Косвенный индекс не является полным документом. |
| Выборка превышает ограничение изображений | Выберите меньше страниц. Один очень большой скан может превышать постраничный предел, даже если сжатый файл мал. |
| В PDF нет выделяемого текста | Этот конвертер создаёт изображения страниц. Если нужны выделение или поиск текста, используйте OCR после преобразования. |
Нет. PDF содержит декодированные изображения страниц. Если нужен поисковый текст, выполните OCR результата и затем проверьте распознавание.
Косвенный индекс ссылается на другие файлы и не предоставляет все страницы самостоятельно. Инструменту нужен автономный или объединённый документ; зависимости он не скачивает.
Нет. DjVu и PDF могут по-разному кодировать изображения страниц. PDF может оказаться больше, особенно если сжатие изображений в DjVu уже было эффективным.