Una sección por página de origen
El HTML identifica las páginas de origen seleccionadas para que el lector pueda volver a la página correspondiente del PDF.

Crea un documento HTML sencillo a partir de la capa de texto del PDF.
Arrastra aquí tus archivos o usa el botón de abajo.
Hasta 100 MB en total · Los archivos permanecen en tu dispositivo
Revisa aquí la vista previa del documento. Si añades contenido, úsala como guía para colocarlo y comprueba el archivo guardado.
Exporta el texto seleccionable del PDF a un documento HTML sencillo, con una sección por cada página seleccionada. El resultado sirve como referencia de lectura o como punto de partida para la edición web.
La herramienta convierte los caracteres extraídos a su representación segura en HTML y no recrea el contenido interactivo del PDF ni el CSS original. El resultado es una representación textual, no una versión web visualmente idéntica al PDF.
El HTML identifica las páginas de origen seleccionadas para que el lector pueda volver a la página correspondiente del PDF.
Los caracteres extraídos se representan de forma segura en HTML. El texto del PDF no se ejecuta como código HTML incrustado.
Crea un documento de referencia más pequeño seleccionando solo las páginas relevantes para tu tarea.
La descarga se abre como documento de texto HTML. No reproduce las fuentes, las imágenes ni el CSS de las páginas originales.
HTML facilita consultar el texto extraído en un navegador o entregarlo a un editor web. Este conversor crea secciones de texto identificadas por página, útiles como referencia mientras se prepara una página web adecuada. No deduce encabezados semánticos, no recrea tablas ni genera una publicación accesible completa. Después de convertir, organiza el contenido en encabezados y párrafos significativos, verifica el orden de lectura y añade por separado las imágenes cuyo uso esté permitido. Si necesitas una vista previa visual fija, utiliza la representación de páginas como imágenes.
Recuperan el texto aprobado de un folleto para redactar una página web. Sustituyen las secciones genéricas por encabezados significativos y comprueban que los saltos de línea no hayan dividido las frases.
Crean una referencia legible en el navegador a partir de un procedimiento en PDF centrado en texto. Conservan las referencias a las páginas originales mientras preparan un artículo revisado para el sistema del equipo.
Comparan el diseño fijo del PDF con una representación sencilla del texto en HTML. Identifican la estructura, las descripciones de imágenes y el marcado de tablas que deben añadir manualmente para crear una edición web útil.
Elige un PDF basado en texto para extraerlo a HTML.
Selecciona la captura para ampliarla.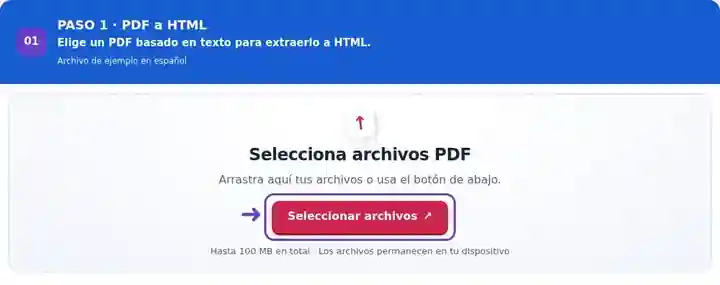
Indica las páginas de origen y, si lo deseas, el nombre de descarga.
Selecciona la captura para ampliarla.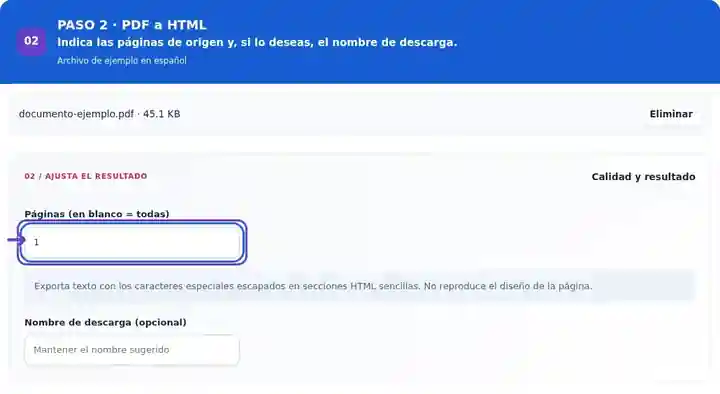
Descarga el HTML y revisa las secciones de texto identificadas por página.
Selecciona la captura para ampliarla.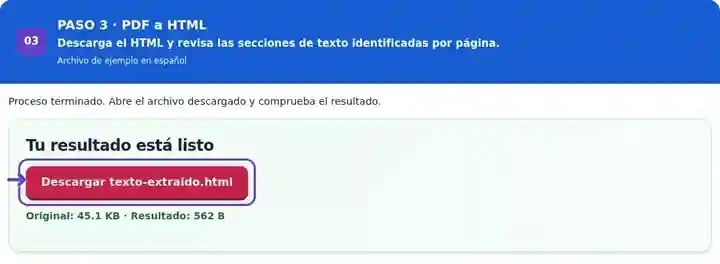
Las capturas muestran estas herramientas con archivos de ejemplo sin datos sensibles. El nombre de tu archivo, el número de páginas y los ajustes pueden ser diferentes.
| Ajuste | Qué puedes esperar |
|---|---|
| Formato de entrada | |
| Lugar de procesamiento | Tu navegador |
| Selección de archivos | Un archivo de entrada |
| Tamaño de entrada | 100 MB en total; las imágenes y páginas decodificadas también tienen límites de píxeles |
| Selección de páginas | Hasta 200 páginas seleccionadas por tarea. Dejar Páginas en blanco incluye todas las páginas solo si el PDF tiene 200 páginas o menos; usa intervalos separados para documentos más largos. |
Esta exportación necesita una capa de texto existente. Las páginas escaneadas requieren OCR revisado para que su texto aparezca en el HTML generado.
El límite de una página impresa rara vez coincide con una sección web completa. Al editar la exportación, agrupa los párrafos bajo encabezados que describan su tema, aplica el marcado de filas y columnas correspondiente a las tablas y añade texto explicativo para los diagramas importantes. El texto preformateado generado es una referencia para editar, no una prueba de que el documento original ya sea una página web terminada. Compara el contenido con el PDF antes de eliminar las etiquetas de las páginas de origen.
| Situación | Qué hacer |
|---|---|
| Falta el diseño de la página | Esta función exporta el texto del PDF a HTML; no reconstruye el diseño visual. |
| Una página escaneada aparece sin contenido | Añade y verifica primero una capa de texto OCR. |
| Los caracteres parecen código HTML | Se representan de forma segura deliberadamente para que el contenido extraído del documento no se ejecute. |
Un título impreso como «Plan del proyecto» puede aparecer dentro del texto pre exportado. Tras confirmar que es el título del documento, un editor podría marcarlo como <h1>Plan del proyecto</h1> y colocar la prosa siguiente en elementos p. Elige la estructura según el significado del texto, no solo por dónde termina la página PDF.
La exportación incluye el texto extraído con caracteres representados de forma segura. No reconstruye las imágenes, los enlaces activos ni el estilo original de las páginas.
Revisa primero su contenido, accesibilidad y formato. Añade un diseño web adecuado en lugar de considerar el texto extraído como un sitio completo.
Sí. Abre el archivo descargado en un editor de texto o HTML. Revisa los caracteres extraídos y añade una estructura adecuada antes de incorporarlo a una página publicada.
Continúa con HTML a PDF, OCR de PDF, PDF a texto.