排序筛选源段落
按中文和英语词语频率选择最多 12 个提取段落。工具不会改写段落,也不提供自定义长度控件。

在本地选取重要的原文片段,并附带页码引用。
将文件拖到此处,或使用下方按钮选择文件。
上限为 100 MB 总计 · 文件保留在您的设备上
在此预览文档。对于新添加的内容,预览仅用于辅助确定位置;请检查保存后的输出结果。
从可选择的 PDF 文字创建简短阅读辅助材料。浏览器按中文和英语词语的重复频率为提取段落评分,最多选择 12 段,再按源顺序作为 TXT 文件返回,每段附有源页码引用。选择前会尝试连接普通换行正文,但分栏、标题、缩写和不完善的文字提取仍可能产生不完整或不自然的段落。
结果引用提取的原文,不会生成新的解释。不使用外部 AI 服务。排名不能确立作者的主要论点,也不会核实事实;不常见却重要的限定条件,可能比频繁重复的文字得分更低。
按中文和英语词语频率选择最多 12 个提取段落。工具不会改写段落,也不提供自定义长度控件。
评分后,所选段落会按源顺序返回,后面的章节不会仅因得分更高就排到前面。
保存带有 [第 N 页] 引用的 TXT 结果,再按这些实际页面位置在源文件中检查各个所选段落。
浏览器执行文字提取和评分,不会将文字发送给生成式 AI 服务。
使用简短摘录来制定阅读计划:识别重复主题,选择可能有用的章节,再返回源文件查看细节。围绕单一主题的章节,词汇通常比混合无关报告的资料包更集中。因此,学习或文档审核前选择页面很有用,尤其适合已经了解源文件、希望重新唤起记忆的情况。
用所选段落识别可能的主题,再阅读章节并编写自己的大纲。将摘录与可能被遗漏的定义、示例和例外情况比较。
在审核会议前回顾重复出现的主题。请在源文件中核实日期和限定条件,不要把单独提取的一句话作为决定引用。
使用简短摘录判断哪些源章节值得细读。通过阅读这些章节评估相关性;词频不能确立证据质量或事实准确性。
选择具有可读文本层的 PDF。
点击截图可放大查看。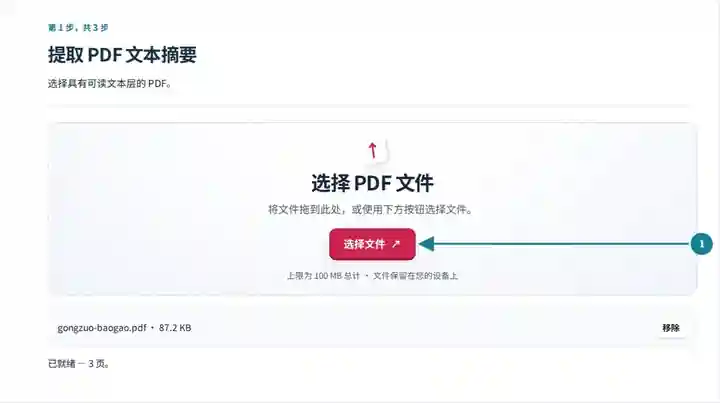
选择参与原文片段提取的页面。
点击截图可放大查看。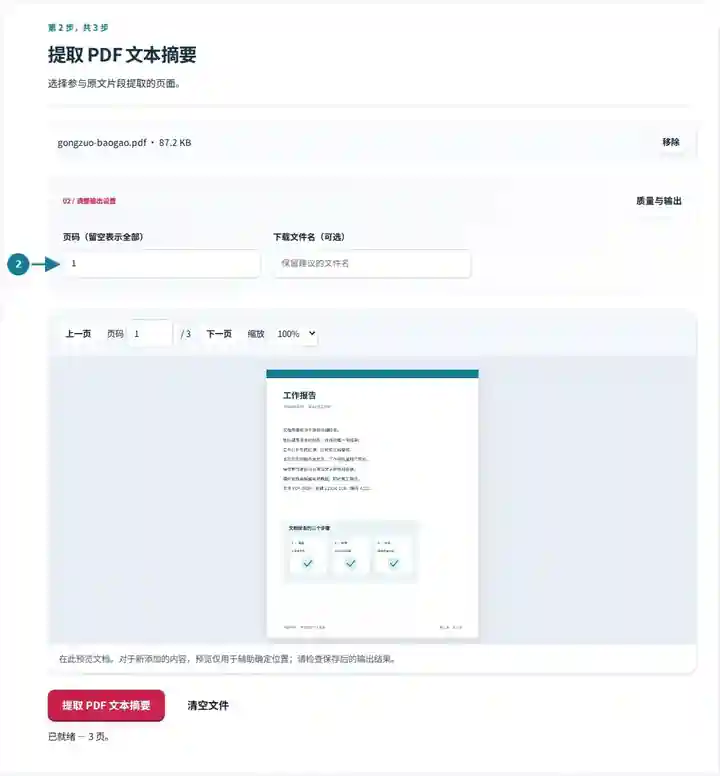
下载 TXT 摘要,按照页码引用定位原文,并结合上下文阅读每段内容。
点击截图可放大查看。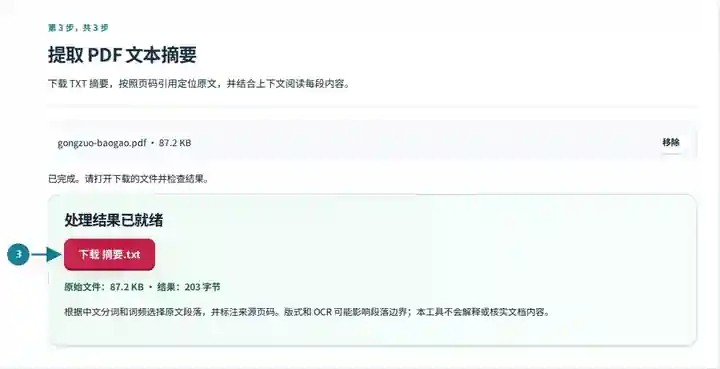
截图展示了使用不含敏感信息的示例文件操作本工具箱的过程。您的文件名、页数和设置可能不同。
| 设置 | 预期效果 |
|---|---|
| 支持的输入 | |
| 处理位置 | 您的浏览器 |
| 文件选择 | 一个输入文件 |
| 输入大小 | 总计 100 MB;解码后的图像和页面也有像素限制 |
| 页面选择 | 每次任务最多选择 200 页。只有 PDF 不超过 200 页时,“页面”留空才表示所有页面;更长文档请分范围处理。 |
| 摘要长度 | 目标是选择约 20% 的合格段落,目标最少三段、最多 12 段。如果合适段落不足三段,就返回已有段落。不提供可调长度控件。 |
纯图像扫描件须先具备经过检查的 OCR 文字层。此界面的评分采用适合中文的分词方式,并识别英语词语;对于采用其他文字体系或分词规则的语言,不应将其视为可靠摘要方法,请使用对应语言界面。
词频评分偏向重复词汇,因此可能更青睐页眉、标准通知或频繁讨论的次要主题。它无法判断某句话是否依赖前面的例外条件。表格行和多栏布局也可能按不便阅读的顺序提取。对于重要引文,请找到原文和上下文;不要仅因 TXT 段落以标点结尾,就假定它完整。
| 情况 | 处理方法 |
|---|---|
| 摘要重复模板文字 | 将“页面”限制为相关章节;排除重复封面或附录可能改变所选段落。 |
| 扫描文档没有摘要 | 需要可读文字层。条件允许时,请先进行 OCR。 |
| 某段文字似乎不完整或有误导性 | 阅读其周围段落。提取不会理解每项依赖关系或限定条件。 |
如果一份 40 页报告的结论在第 12–18 页,请先对该范围生成摘要。按 TXT 结果中的 [第 N 页] 引用,在标明的实际 PDF 页面定位该短语;印刷的章节页码可能使用不同编号。如果摘录主要集中在重复项目名上,请直接查看结论标题,并编写自己的大纲。此示例展示一种审核方法,不保证评分能识别每项结论。
不是。它在浏览器中按中文和英语词语频率选择提取的源段落,既不撰写新分析,也不核查段落真伪。
请先通过 OCR 添加文字层。识别错误会影响所选段落。
不能。请将其用作导航辅助,并核实完整的相关段落及限定条件。
没有长度控件。工具选择少量合格段落,最多 12 段。可选择不同页面范围来改变源材料;如果需要完整提取文字,请使用“PDF 转文本”。
使用以下工具选择源页面子集: 提取 PDF 页面。继续使用 PDF 转文本、 PDF 文字识别(OCR)、 使用 PDF 笔记学习。